Bản đồ model AI mở 2026: chọn model theo việc và theo máy
Mỗi tháng lại có model mở mới, tên gọi thì dài và khó hiểu. Bài viết vẽ bản đồ các họ model chính, giải thích dense và MoE, giấy phép dùng cho kinh doanh, gợi ý model theo việc và theo máy, kèm cách tự thử tiếng Việt. Dữ kiện kiểm tra trên model card và ollama.com ngày 07/10/2026.
Mở thư viện model và gặp hàng trăm cái tên
Chị Mai phụ trách marketing cho một chuỗi spa. Chị đã cài xong Ollama, mở thư viện model và thấy một loạt tên như qwen3.6:35b, gemma4:26b, gpt-oss:20b, glm-4.7-flash. Model nào viết caption tiếng Việt được? Model nào vừa máy 16GB? Model nào được dùng cho kinh doanh? (Tình huống minh hoạ.)
Bài này không chấm "model nào hơn model nào", mà giúp bạn đọc bản đồ: có những họ model nào, hợp với việc gì, máy cỡ nào, giấy phép ra sao, rồi tự thử trên việc thật. Cách tính máy nào chạy được model nào nằm ở Cấu hình máy tính chạy AI Local.
Model AI mở là gì và cách đọc tên model
Model AI mở (open-weight) là model mà hãng công bố file trọng số để bạn tải về chạy trên máy của mình; mỗi model đi kèm một giấy phép riêng quy định được dùng vào việc gì.
OpenAI gọi gpt-oss là "open-weight models" của họ; model card Gemma 4 ghi bản phát hành gồm các model "open-weights". "Mở trọng số" không đồng nghĩa với "dùng thương mại tự do": phải xem giấy phép của từng model. Ngược lại, model đóng như Claude, GPT chạy trên máy chủ của hãng, bạn gửi dữ liệu lên và trả tiền theo token.
| Phần trong tên | Ý nghĩa | Ví dụ |
|---|---|---|
| Họ và phiên bản | Hãng và đời model | Qwen3.6, Gemma 4, Llama 4 |
| Số + B | Tổng số tham số, tính bằng tỷ | 27B = khoảng 27 tỷ tham số |
| A + số + B | Số tham số kích hoạt mỗi lần (model MoE) | Qwen3.6-35B-A3B: tổng 35B, kích hoạt 3B |
| E + số + B (Gemma) | Cỡ "hiệu dụng" | Gemma 4 E2B: 2,3B hiệu dụng, 5,1B tính cả lớp nhúng |
| Tag Ollama | Tên để tải bằng lệnh ollama pull | qwen3.6:35b, gemma4:12b |
| q4_K_M, q8_0, bf16 | Mức lượng tử hoá (xem L2) | qwen3.8:27b-q8_0 30GB |
| Hậu tố -cloud | Chạy trên máy chủ Ollama, dữ liệu rời máy bạn | gemma4:31b-cloud |
qwen3.6:35b, bên cạnh các tag dài như qwen3.6:35b-a3b-q8_0. Tag không ghi mức lượng tử thường là bản nén khoảng 4-bit: qwen3.8 chính là qwen3.8:27b, 18GB.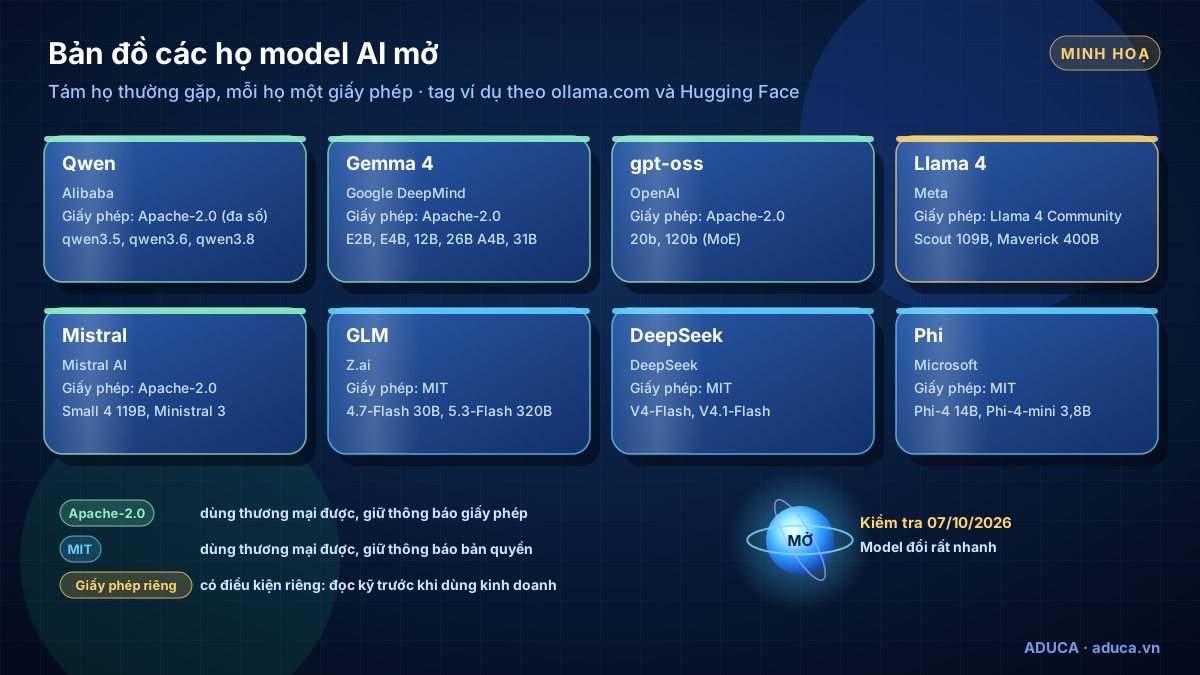
Nguồn: gpt-oss-20b · Gemma 4 · Qwen3.6-35B-A3B · Ollama – qwen3.6 · Ollama – qwen3.8
Dense và MoE: chạy nhanh khác với tốn bộ nhớ
- Dense: mọi tham số đều tham gia tính mỗi chữ (token). Ví dụ Qwen3.8-27B, Gemma 4 31B, Phi-4.
- MoE (Mixture-of-Experts, "hỗn hợp chuyên gia"): model gồm nhiều nhóm chuyên gia, mỗi lần chỉ gọi một phần. Gemma giải thích bản 26B A4B chỉ kích hoạt khoảng 4B tham số nên chạy nhanh hơn nhiều so với tổng 26B. Ví dụ khác: Qwen3.6-35B-A3B, gpt-oss, GLM-4.7-Flash (30B-A3B), Qwen3-Coder-Next (80B-A3B), Mistral Small 4 (119B, 6,5B kích hoạt).
Điểm hay bị hiểu nhầm: MoE vẫn cần bộ nhớ cho toàn bộ tham số. File gemma4:26b nặng 16–19GB, gần bằng gemma4:31b dense 19–20GB. Vì vậy MoE giúp nhanh hơn trên máy đã đủ bộ nhớ, chứ không giúp máy ít bộ nhớ chạy được model lớn.
Nguồn: Gemma 4 – MoE · Ollama – gemma4
Bản đồ model AI mở chạy được trên máy cá nhân
Bảng dưới gồm các model có thể chạy trên máy cá nhân hoặc máy trạm, kiểm tra ngày 07/10/2026. Dung lượng là file trên ollama.com; "điểm đáng chú ý" lấy từ model card do hãng tự công bố, không phải đánh giá độc lập.
| Model (hãng) | Cỡ, kiểu | Giấy phép | Tag Ollama, dung lượng file | Điểm đáng chú ý (theo model card) |
|---|---|---|---|---|
| Qwen3.5 (Alibaba) | 0.8B, 2B, 4B, 9B, 27B dense; 35B-A3B, 122B-A10B, 397B-A17B MoE | Apache-2.0 | qwen3.5:4b 3,3–4,0GB; :9b 6,6–7,6GB; :27b 17–20GB; :35b 22GB; :122b 81GB | 201 ngôn ngữ và phương ngữ; context 262.144; có xử lý hình ảnh |
| Qwen3.6 (Alibaba) | 27B dense; 35B-A3B MoE | Apache-2.0 | qwen3.6:27b 18–19GB; qwen3.6:35b 23–24GB | Hãng ghi mạnh về gọi công cụ (tool calling) |
| Qwen3.8-27B (Alibaba) | 27B dense, đọc ảnh và video | Apache-2.0 | qwen3.8 18GB; 27b-q8_0 30GB | Context 262.144 |
| Qwen3-Coder-Next (Alibaba) | 80B MoE, 3B kích hoạt | Apache-2.0 | qwen3-coder-next 52GB (q4_K_M) | Dành cho lập trình và agent |
| Gemma 4 (Google DeepMind) | E2B, E4B, 12B, 31B; 26B A4B là MoE (25,2B tổng, 3,8B kích hoạt) | Apache-2.0 | gemma4:e2b-it-qat 4,3GB; :e4b 6,6–9,5GB; :12b 7,7–8,0GB; :26b 16–19GB; :31b 19–20GB | Hơn 35 ngôn ngữ dùng ngay, huấn luyện trước trên hơn 140; đọc ảnh; hỗ trợ dùng công cụ có cấu trúc |
| gpt-oss (OpenAI) | 20b: 21B tổng, 3,6B kích hoạt; 120b: 117B, 5,1B (MoE) | Apache-2.0 | gpt-oss:20b 14GB; gpt-oss:120b 65GB | Bản 20b chạy trong 16GB bộ nhớ; bản 120b vừa một GPU 80GB |
| Llama 4 Scout (Meta) | 109B tổng, 17B kích hoạt (MoE) | Llama 4 Community License | llama4:scout 67GB (q4) | Có tiếng Việt trong 12 ngôn ngữ hỗ trợ; context 10M |
| Mistral Small 4 (Mistral AI) | 119B MoE, 6,5B kích hoạt | Apache-2.0 | Chưa thấy trên thư viện Ollama; khoảng 73GB ở Q4 (ước tính) | Có mã vi trong thông tin ngôn ngữ; gọi hàm sẵn; context 256k |
| Ministral 3 (Mistral AI) | 3B, 8B, 14B | Apache-2.0 | ministral-3:3b 3,0GB; :8b 6,0GB; :14b 9,1GB | Dành cho thiết bị biên; context 256k |
| GLM-4.7-Flash (Z.ai) | 30B-A3B MoE | MIT | glm-4.7-flash 19GB; :q8_0 32GB | Thông tin ngôn ngữ ghi tiếng Anh, tiếng Trung |
| Phi-4, Phi-4-mini (Microsoft) | 14B dense; 3,8B dense | MIT | phi4-mini 2,5GB | Phi-4-mini: 23 ngôn ngữ, không có tiếng Việt |
Các model rất lớn dưới đây có trọng số mở nhưng vượt xa máy phổ thông; thường dùng qua API của hãng hoặc máy chủ nhiều GPU:
- Qwen3.8-Flash-Next: 125B (6B kích hoạt), cộng thêm 51B n-gram embedding và 4B MTP; giấy phép qwen-community-1.0, không phải Apache.
- Qwen3.8-2.4T-A95B: khoảng 2.400 tỷ tham số, giấy phép riêng "qwen3.8-max".
- GLM-5.3-Flash: 320B tổng, 18B kích hoạt, đa phương thức, MIT; khoảng 196GB ở Q4 (ước tính).
- DeepSeek-V4-Flash: 284B tổng, 13B kích hoạt; V4-Pro: 1.600B, 49B kích hoạt; context 1M, MIT.
- DeepSeek-V4.1-Flash: 552B tham số phần lõi (kích hoạt "8B / 16B") cộng Engram 196B, tổng file trên Hugging Face khoảng 763B; context 1M, MIT; khoảng 466GB ở Q4 (ước tính).
- Llama 4 Maverick: 400B tổng, 17B kích hoạt;
llama4bản maverick q4 nặng 245GB.
Nguồn: Qwen3.5 · Qwen3.6 · Qwen3.8 · Qwen3-Coder-Next · Qwen3.8-Flash-Next · Gemma 4 · gpt-oss · Llama 4 · Mistral Small 4 · Ministral 3 · GLM-4.7 · GLM-5.3 · DeepSeek-V4 · DeepSeek-V4.1 · Phi-4 · Phi-4-mini · Ollama Library
Giấy phép: model nào dùng cho kinh doanh được?
| Nhóm giấy phép | Model (ví dụ) | Cần lưu ý |
|---|---|---|
| Apache-2.0 | Qwen3.5, Qwen3.6, Qwen3.8-27B, Qwen3-Coder-Next, Gemma 4, gpt-oss, Mistral Small 4, Ministral 3 | Dùng thương mại được; giữ thông báo giấy phép khi phân phối lại |
| MIT | GLM-4.7-Flash, GLM-5.3-Flash, DeepSeek V4, Phi-4, Phi-4-mini | Dùng thương mại được; giữ thông báo bản quyền |
| Llama 4 Community License | Llama 4 Scout, Maverick | Thương mại được nhưng: trên 700 triệu người dùng/tháng phải xin phép Meta; hiển thị "Built with Llama"; model phái sinh đặt tên bắt đầu bằng "Llama"; tuân thủ chính sách sử dụng; phải đăng nhập, đồng ý điều khoản mới tải được |
| Giấy phép riêng của Qwen | Qwen3.8-Flash-Next (qwen-community-1.0), Qwen3.8-2.4T (qwen3.8-max) | Không phải Apache; đọc toàn văn trước khi dùng cho kinh doanh |
Giấy phép có thể đổi giữa hai đời của cùng một họ. Ví dụ Gemma 4 dùng Apache-2.0, trong khi Gemma 3 dùng Gemma Terms of Use; model nhúng EmbeddingGemma (300m) cũng theo giấy phép Gemma. Llama 3.1 dùng Llama 3.1 Community License. Vì vậy hãy kiểm tra giấy phép theo đúng bản bạn tải, không suy từ tên họ.
Nguồn: Qwen3.8-Flash-Next – license · Llama 4 License · Ollama – gemma3 · EmbeddingGemma 300m · Llama 3.1
Gợi ý model theo việc
- Việc cần làmViết, trả lời khách, phân loại, code, đọc ảnh
- Giấy phépCó cho dùng thương mại không, điều kiện gì
- Máy đang cóDung lượng file phải nhỏ hơn rõ rệt bộ nhớ
- Chọn 2–3 ứng viênCùng nhóm việc, vừa máy
- Tự thử bằng việc thậtChấm điểm rồi mới quyết định
| Việc | Model phù hợp để thử | Căn cứ (theo model card) | Mức máy (ước tính) |
|---|---|---|---|
| Viết content, tóm tắt tiếng Việt | qwen3.5:9b, gemma4:12b; máy lớn hơn: qwen3.8, gemma4:31b | Qwen3.5: 201 ngôn ngữ; Gemma 4: hơn 35 ngôn ngữ dùng ngay | 16GB; 24–36GB cho bản 27–31B |
| Chatbot, agent gọi công cụ | qwen3.6:35b, qwen3.6:27b, gemma4:26b | Qwen3.6 ghi mạnh về gọi công cụ; Gemma 4 hỗ trợ dùng công cụ có cấu trúc | 24GB trở lên, context từ 64k |
| Phân loại, trích thông tin ngắn | qwen3.5:4b, ministral-3:8b, gemma4:e4b | File nhỏ, chạy nhanh trên máy phổ thông | 8–16GB |
| Lập trình | qwen3-coder:30b 19GB, devstral:24b 14GB, qwen3-coder-next 52GB | Model dành riêng cho code, đều Apache-2.0 | 24GB; 64GB cho coder-next |
| Đọc hình ảnh (ảnh sản phẩm, ảnh chụp tài liệu) | qwen3.8, qwen3.5, gemma4 | Qwen3.8-27B đọc ảnh và video; Qwen3.5 có vision; Gemma 4 đọc ảnh | Tuỳ cỡ chọn |
Agent và tài liệu dài cần context lớn (Ollama khuyên ít nhất 64.000 token), nên cần dư bộ nhớ. Việc khó, cần chất lượng cao: cân nhắc model đám mây (xem Claude làm bộ não AI Agent, GPT làm bộ não AI Agent). Chi tiết từng ứng dụng: viết content, chatbot, lập trình, bộ não cho AI Agent.
Nguồn: Qwen3.5 · Qwen3.6 · Gemma 4 · Qwen3.8-27B · Ollama – qwen3-coder · Ollama – devstral · Mistral – Devstral · Ollama – Context length
Model nhỏ cho máy yếu
Với máy khoảng 8GB bộ nhớ, chọn model có file dưới khoảng 4GB trên ollama.com:
qwen3.5:0.8b(1,2–1,3GB),qwen3.5:2b(2,7–3,1GB),qwen3.5:4b(3,3–4,0GB): Apache-2.0, 201 ngôn ngữ.gemma4:e2b-it-qat(4,3GB): Apache-2.0, Google mô tả dành cho thiết bị di động và thiết bị biên.ministral-3:3b(3,0GB): Apache-2.0.phi4-mini(2,5GB): MIT; model card không liệt kê tiếng Việt và cảnh báo ngôn ngữ ngoài tiếng Anh sẽ kém hơn.
Model nhỏ hợp với việc ngắn, rõ khuôn: phân loại, trích tên, số điện thoại, tóm tắt ngắn.
Nguồn: Ollama – qwen3.5 · Ollama – gemma4 · Ollama – ministral-3 · Ollama – phi4-mini · Phi-4-mini
Model embedding cho hỏi đáp tài liệu (RAG)
RAG là cách cho AI trả lời dựa trên tài liệu của bạn: hệ thống tìm đoạn liên quan rồi đưa cho model đọc. Bước tìm cần một model embedding, loại model biến văn bản thành dãy số để so độ gần nghĩa. Một số lựa chọn mở:
| Model | Cỡ, dung lượng | Ngôn ngữ | Context | Giấy phép |
|---|---|---|---|---|
| Qwen3-Embedding | 0.6B / 4B / 8B; Ollama qwen3-embedding 639MB / 2,5GB / 4,7GB | Hơn 100 ngôn ngữ | 32k | Apache-2.0 |
| EmbeddingGemma 2 | 740M tổng; vector 768 chiều, cắt được 512/256/128 | Hơn 100; cả ảnh, video, âm thanh | 8.192 | Apache-2.0 |
| EmbeddingGemma (300m) | Ollama 622MB | Hơn 100 | 2K | Giấy phép Gemma |
| BGE-M3 | 567M; Ollama 1,2GB | Hơn 100 | 8.192 | MIT |
| nomic-embed-text v1.5 | Khoảng 137M | Chưa thấy ghi rõ tiếng Việt | Không ghi | Apache-2.0 |
Ollama, LM Studio, llama-server và vLLM đều gọi embedding được qua đường dẫn /v1/embeddings. Lưu ý thực tế: đổi model embedding thì phải tạo lại chỉ mục tài liệu, vì vector của hai model không so với nhau được. Cách dựng hỏi đáp tài liệu nội bộ: AI Local làm slide, tài liệu, Excel.
Nguồn: Qwen3-Embedding · Ollama – qwen3-embedding · EmbeddingGemma 2 · Ollama – embeddinggemma · Ollama – bge-m3 · BGE-M3 · Ollama – nomic-embed-text
Tự thử tiếng Việt bằng bộ câu hỏi thật
Tại ngày 07/10/2026 chưa có xếp hạng tiếng Việt chính thức cho các model mở. Model card chỉ cho biết có hỗ trợ tiếng Việt hay không: Llama 4 liệt kê tiếng Việt, Mistral Small 4 có mã vi, Qwen3.5 và Gemma 4 ghi số ngôn ngữ, Phi-4-mini không có tiếng Việt. Cách thực tế là tự thử trên chính việc của bạn:
- Soạn 20–30 câu thật chia 5 nhóm: viết, tóm tắt, trả lời khách, phân loại, câu bẫy (hỏi thứ không có trong tài liệu). Ẩn thông tin khách trước khi dùng.
- Chọn 2–3 model vừa máy, cùng mức lượng tử, cùng một chỉ dẫn chung.
- Chạy từng câu, lưu câu trả lời vào bảng, đổi tên thành "Bài 1, 2, 3" để người chấm không biết của model nào.
- Hai người chấm độc lập, thang 1–5 theo năm tiêu chí: đúng dữ kiện, chính tả và dấu, đúng giọng, đúng định dạng, không bịa.
- Ghi lại tag model, mức lượng tử, ngày thử; thử lại khi có bản mới.
Bộ câu hỏi thử tiếng Việt – <tên doanh nghiệp> – ngày thử <ngày>
Chỉ dẫn chung (dán giống nhau cho mọi model):
Bạn là trợ lý của <tên doanh nghiệp>. Trả lời bằng tiếng Việt có dấu, xưng "mình – bạn".
Chỉ dùng thông tin trong phần TÀI LIỆU; không có thì nói "cần nhân viên kiểm tra".

Nhóm 1 – Viết: viết caption 80 chữ cho <sản phẩm>, giọng <thân thiện / chuyên nghiệp>.
Nhóm 2 – Tóm tắt: tóm tắt đoạn TÀI LIỆU sau thành 5 gạch đầu dòng: <dán 1 trang tài liệu thật, đã ẩn thông tin khách>
Nhóm 3 – Trả lời khách: khách hỏi "<câu hỏi thật của khách>", trả lời dựa trên bảng giá: <dán bảng giá>
Nhóm 4 – Phân loại: xếp tin nhắn sau vào nóng / ấm / lạnh, trả về đúng 1 từ: <tin nhắn>
Nhóm 5 – Bẫy: hỏi một thông tin KHÔNG có trong tài liệu, xem model có bịa không.

Chấm mỗi câu thang 1–5: đúng dữ kiện · chính tả và dấu · đúng giọng · đúng định dạng · không bịaollama pull qwen3.5:9b # tải model thứ nhất
ollama pull gemma4:12b # tải model thứ hai
ollama run qwen3.5:9b # chat, dán từng câu trong bộ thử; gõ /bye để thoát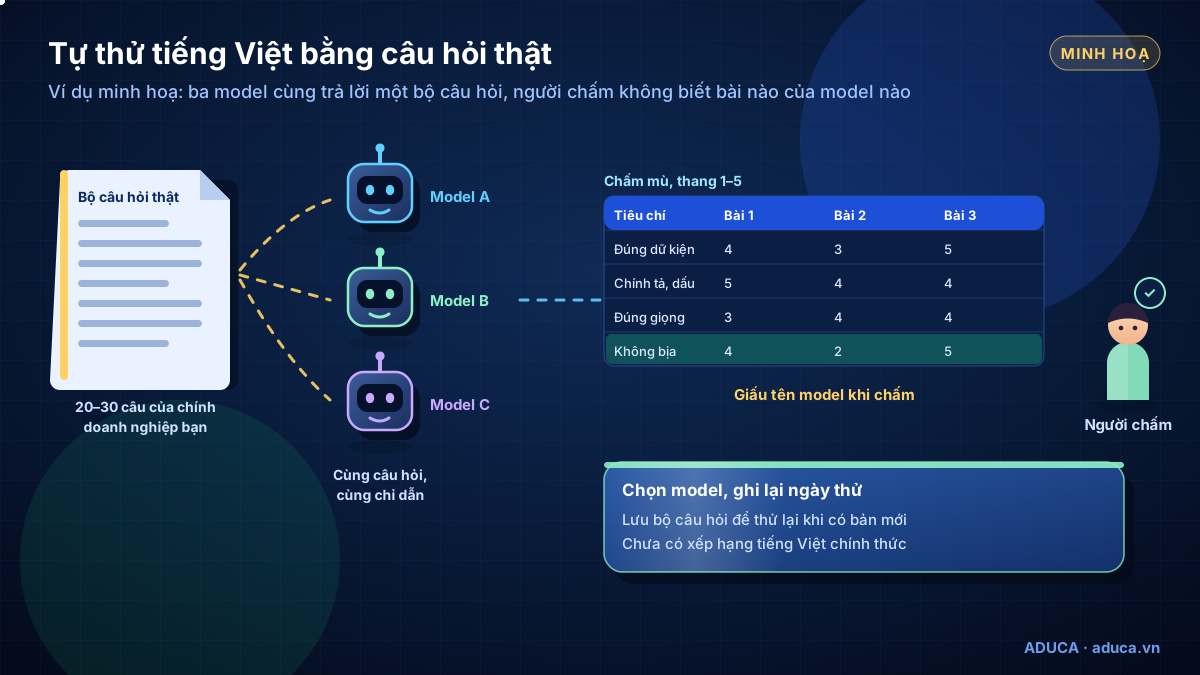
Nguồn: Llama 4 · Mistral Small 4 · Qwen3.5 · Gemma 4 · Phi-4-mini
Model đổi rất nhanh: giữ bản đồ luôn mới
Chỉ trong vài tháng năm 2026 đã có Qwen3.5 (02/2026), Qwen3.6 (04/2026), Qwen3.8-27B (05/08/2026), Qwen3.8-Flash-Next (24/08/2026), GLM-5.3-Flash (25/08/2026), DeepSeek-V4.1-Flash (10/09/2026). Ngược lại, tại ngày kiểm tra chưa thấy Llama mới hơn Llama 4, chưa thấy model trò chuyện mở mới của OpenAI ngoài gpt-oss và gpt-oss-safeguard, chưa thấy Phi-5.
- Mỗi quý xem lại ollama.com và trang Hugging Face của hãng bạn dùng.
- Có bản mới: chạy lại bộ câu hỏi thử, so với model đang dùng rồi mới đổi.
- Mỗi lần đổi model: đọc lại giấy phép của đúng bản mới.
- Tránh nhầm tag
-cloudvới bản chạy trên máy: bản cloud gửi dữ liệu lên máy chủ Ollama.
Nguồn: Hugging Face – meta-llama · Hugging Face – openai · Ollama FAQ – cloud models
Bắt đầu từ đâu?
- Chọn một việc cụ thể (ví dụ viết caption hoặc phân loại tin nhắn) và soạn bộ câu hỏi thử.
- Tra mức máy ở Cấu hình máy tính chạy AI Local, chọn 2–3 model cùng nhóm việc, kiểm tra giấy phép.
- Cài theo Cài AI Local trong 30 phút, chạy bộ thử, chấm mù rồi mới đưa vào việc thật.
Muốn được tư vấn hoặc cài đặt AI Local theo nhu cầu riêng, bạn có thể đăng ký Tư vấn 1-1 hoặc Coaching 1-1 cho doanh nghiệp; chi phí báo sau buổi tư vấn.
Đọc tiếp: Cài AI Local →
Câu hỏi thường gặp
Model AI mở nào hợp với tiếng Việt?
Tại ngày 07/10/2026 chưa có xếp hạng tiếng Việt chính thức cho các model mở. Model card chỉ ghi danh sách hoặc số ngôn ngữ: Qwen3.5 ghi 201 ngôn ngữ và phương ngữ, Gemma 4 ghi hơn 35 ngôn ngữ dùng ngay và huấn luyện trước trên hơn 140, Llama 4 liệt kê tiếng Việt, Mistral Small 4 có mã vi trong thông tin ngôn ngữ, còn Phi-4-mini không có tiếng Việt. Cách thực tế là tự thử 2–3 model bằng bộ câu hỏi thật của doanh nghiệp.
Model AI mở có được dùng cho kinh doanh không?
Phần lớn được, nhưng tuỳ giấy phép. Apache-2.0 (Qwen3.5, Qwen3.6, Gemma 4, gpt-oss, Mistral Small 4) và MIT (GLM, DeepSeek, Phi-4) cho phép dùng thương mại, cần giữ thông báo giấy phép. Llama 4 Community License có thêm điều kiện như ghi "Built with Llama" và xin phép Meta khi sản phẩm vượt 700 triệu người dùng mỗi tháng. Một số bản Qwen mới dùng giấy phép riêng. Luôn đọc điều khoản trước khi dùng.
MoE là gì, có giúp tiết kiệm RAM không?
MoE (Mixture-of-Experts) là model chia thành nhiều nhóm chuyên gia, mỗi lần chỉ kích hoạt một phần tham số nên chạy nhanh hơn model dense cùng tổng cỡ. Nhưng MoE không tiết kiệm bộ nhớ: máy vẫn phải nạp toàn bộ tham số. Ví dụ trên Ollama, gemma4:26b (MoE) nặng 16–19GB, gần bằng gemma4:31b (dense) 19–20GB.
Máy yếu nên dùng model nào?
Với máy khoảng 8GB bộ nhớ, có thể thử các model có file dưới khoảng 4GB trên ollama.com: qwen3.5:0.8b, qwen3.5:2b, qwen3.5:4b (Apache-2.0), ministral-3:3b (Apache-2.0), gemma4:e2b-it-qat (Apache-2.0). phi4-mini (MIT) nhẹ nhưng model card không liệt kê tiếng Việt.
Model embedding là gì, khi nào cần?
Model embedding biến đoạn văn thành dãy số để máy tìm đoạn có nghĩa gần với câu hỏi. Bạn cần nó khi dựng hỏi đáp trên tài liệu nội bộ (RAG). Một số model embedding mở chạy được bằng Ollama: qwen3-embedding, embeddinggemma-2, bge-m3, đều ghi hỗ trợ hơn 100 ngôn ngữ.
Tài liệu liên quan
- AI Local · AI AgentAI Local là gì? Chạy AI ngay trên máy tính, không tốn phí APIAI Local là gì: chạy model AI mở ngay trên máy tính của bạn, không trả phí API theo lượt, dữ liệu ở lại máy. Lợi ích, giới hạn, so sánh với AI đám mây.
- AI Local · AI AgentCấu hình máy tính chạy AI Local: RAM, VRAM, Mac hay PC NVIDIACấu hình máy tính chạy AI Local: RAM, VRAM quyết định model nào chạy được, cách ước tính dung lượng theo Q4/Q8, Mac hay PC NVIDIA, ổ cứng, mua máy hay thuê GPU.
- AI Local · AI AgentCài AI Local trong 30 phút: Ollama, LM Studio và Open WebUICài AI Local từng bước trên Windows, macOS, Linux: chọn Ollama, LM Studio, Jan hay llama.cpp, chạy thử model nhỏ, đặt context, dựng Open WebUI cho nhóm.
- AI Local · AI AgentAI Local viết content: bài đăng, caption, kịch bản, emailAI Local viết content trên máy: chọn model mở theo giấy phép, prompt hệ thống giữ giọng thương hiệu, mẫu lệnh caption, kịch bản, email, quy trình duyệt.
Xem tất cả tài liệu hướng dẫn →
Đăng ký Tư vấn 1-1 về AI Local
Chuyên gia Aduca cùng bạn xem nhu cầu, máy đang có và dữ liệu cần bảo vệ, rồi đề xuất nên chạy AI Local, dùng đám mây hay kết hợp. Dịch vụ cài AI Local nằm trong gói Tư vấn 1-1 hoặc Coaching 1-1; chi phí báo sau buổi tư vấn.
Nguồn tham khảo
- Hugging Face – Qwen3.5 model card
- Hugging Face – Qwen3.6-35B-A3B model card
- Hugging Face – Gemma 4 model card
- Hugging Face – gpt-oss-20b model card
- Meta – Llama 4 Community License
- Hugging Face – Mistral Small 4 model card
- Hugging Face – GLM-4.7-Flash model card
- Hugging Face – DeepSeek-V4.1-Flash model card
- Hugging Face – Phi-4-mini-instruct model card
- Ollama Library – tag và dung lượng file
Lịch sử cập nhật
- 07/10/2026 — Bản đầu.
Miễn trừ trách nhiệm
Bài viết thuộc chuỗi kiến thức của Công ty Cổ phần Giáo dục Aduca, chia sẻ miễn phí cho mục đích học tập. Thông tin kỹ thuật đối chiếu với tài liệu chính thức của các dự án và nền tảng tại ngày cập nhật (có ghi nguồn); phần nhận định là quan điểm của Aduca. OpenClaw, Hermes Agent, Claude (thương hiệu của Anthropic), ChatGPT (thương hiệu của OpenAI), n8n (thương hiệu của n8n GmbH), các phần mềm chạy model và các model AI mở (Ollama, LM Studio, Qwen, Gemma, gpt-oss…) cùng các phần mềm, dịch vụ nêu trong bài thuộc về chủ sở hữu tương ứng, không thuộc Aduca; Aduca không phải đối tác chính thức của các công ty này. Tính năng, gói và giá có thể thay đổi bất cứ lúc nào – hãy kiểm tra trang chính thức trước khi mua. Kết quả áp dụng phụ thuộc quy trình, dữ liệu và con người của từng doanh nghiệp; bài viết không cam kết doanh thu hay hiệu quả cụ thể. © 2026 Aduca — được trích dẫn khi ghi rõ nguồn aduca.vn.