AI Local cho video và giọng nói: phụ đề, đọc giọng, video ngắn
Chép lời, làm phụ đề, đọc giọng và tạo đoạn video ngắn ngay trên máy của mình. Bài viết chỉ ra việc nào máy phổ thông làm tốt, việc nào cần GPU lớn, giọng đọc tiếng Việt nào dùng thương mại được, tổng hợp từ tài liệu chính thức tại ngày 07/10/2026.
Mỗi video mất cả buổi chỉ để gõ phụ đề
Chủ một shop mỹ phẩm quay ba video ngắn mỗi tuần. Phần quay chỉ mất một giờ, nhưng gõ phụ đề, thu lại giọng giới thiệu sản phẩm và tìm cảnh phụ mất cả buổi. Các bản ghi âm buổi tư vấn khách cũng cần chép lời, nhưng chị ngại tải lên dịch vụ bên ngoài. (Tình huống minh hoạ.)
AI Local giúp được phần lặp lại: chép lời, làm phụ đề, đọc giọng, tạo cảnh phụ ngắn, ngay trên máy của bạn. Nhưng ba việc này có độ sẵn sàng rất khác nhau.
Ba việc, ba mức máy khác nhau
AI Local cho video và giọng nói là dùng model mở chạy trên máy của bạn để chép lời thành văn bản, làm phụ đề, đọc văn bản thành giọng nói và tạo đoạn video ngắn, thay vì gửi tệp lên dịch vụ đám mây.
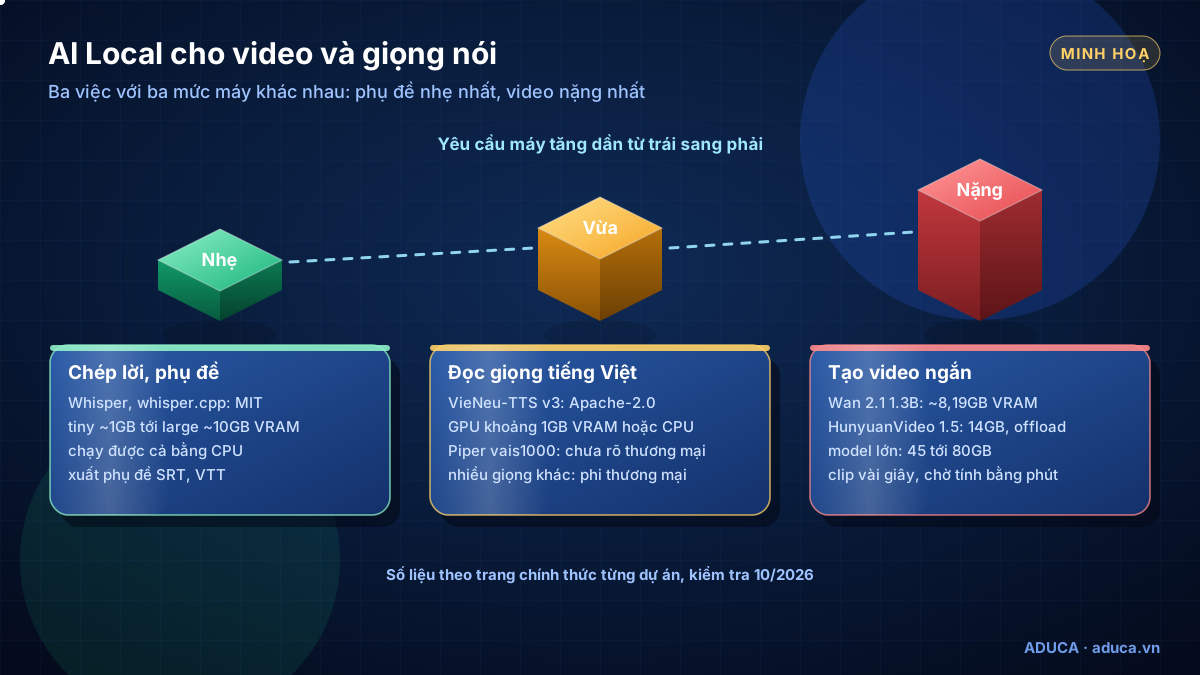
- Chép lời, phụ đề: đã khá chín, chạy được trên laptop phổ thông, kể cả máy chỉ có CPU.
- Đọc giọng tiếng Việt: có vài dự án mở, máy không cần mạnh, nhưng phải chọn đúng giấy phép.
- Tạo video: cần GPU nhiều VRAM, mỗi lần chỉ được vài giây video và phải chờ tính bằng phút.
Nền tảng chung về máy, phần mềm, model xem ở AI Local là gì và Cấu hình máy tính chạy AI Local.
Chép lời và làm phụ đề bằng Whisper
Whisper của OpenAI dùng giấy phép MIT cho cả mã và trọng số, có tiếng Việt (mã vi), xuất phụ đề dạng txt, vtt, srt, tsv, json. Bảng chính thức:
| Bản | Tham số | VRAM cần | Tốc độ tương đối |
|---|---|---|---|
| tiny | 39M | ~1GB | ~10x |
| base | 74M | ~1GB | ~7x |
| small | 244M | ~2GB | ~4x |
| medium | 769M | ~5GB | ~2x |
| large | 1550M | ~10GB | 1x |
| turbo | 809M | ~6GB | ~8x |
Tốc độ đo khi chép tiếng Anh trên GPU A100; README lưu ý tốc độ thực tế có thể khác nhiều. Bản turbo không được huấn luyện cho việc dịch.
- whisper.cpp (MIT): chạy trên macOS, Windows, Linux, iOS, Android; trên Mac chip Apple chạy hoàn toàn bằng GPU qua Metal; hỗ trợ CUDA, Vulkan, ROCm và CPU thuần. Bản small chỉ cần khoảng 852MB RAM, bản large khoảng 3,9GB.
- faster-whisper (MIT): với 13 phút âm thanh trên RTX 3070 Ti 8GB, bản large-v2 fp16 xong trong 1 phút 3 giây, so với 2 phút 23 giây của Whisper gốc; chế độ int8 chỉ dùng 2.926MB VRAM.
- PhoWhisper (VinAI, BSD-3-Clause, dùng thương mại được nếu giữ ghi công): Whisper tinh chỉnh trên 844 giờ tiếng Việt nhiều vùng miền.
# Whisper bản gốc: cần Python và FFmpeg
pip install -U openai-whisper
whisper bai-noi.mp3 --model turbo --language vi --output_format srt# whisper.cpp: sau khi build theo README
sh ./models/download-ggml-model.sh medium
ffmpeg -i bai-noi.mp3 -ar 16000 -ac 1 -c:a pcm_s16le bai-noi.wav
./build/bin/whisper-cli -m models/ggml-medium.bin -f bai-noi.wav -l vi -osrtPhụ đề tạo ra là bản nháp: đọc lại tên riêng, tên sản phẩm, giá và số điện thoại trước khi đăng. Bản ghi âm buổi tư vấn khách là dữ liệu cá nhân; chép lời trên máy giúp tệp không rời máy, nhưng vẫn phải lưu trữ, xoá theo quy định bảo vệ dữ liệu cá nhân.
Nguồn: OpenAI Whisper · whisper.cpp · whisper-cli · faster-whisper · PhoWhisper-large
Đọc giọng tiếng Việt: chọn đúng giấy phép
Đọc văn bản thành giọng nói (TTS) là phần dễ vướng giấy phép nhất. Kiểm tra ngày 07/10/2026:
| Dự án | Giấy phép | Thương mại? | Ghi chú |
|---|---|---|---|
| VieNeu-TTS v3 Turbo | Apache-2.0 (mã và trọng số) | Có | 25 giọng Bắc, Trung, Nam; GPU RTX 3060 dùng 0,9–1,1GB VRAM; chạy được bằng CPU. Bản v4 đóng mã, chỉ có qua API |
| Piper, giọng vi_VN vais1000 | Dữ liệu vais1000 CC BY 4.0; engine hiện là GPL-3.0 | Chưa rõ | Tinh chỉnh từ giọng tiếng Anh lessac, dữ liệu gốc chỉ cho nghiên cứu. Giọng vivos là CC BY-NC-SA (không thương mại) |
| viXTTS | Coqui Public Model License | Không, kể cả âm thanh tạo ra | |
| F5-TTS gốc và bản tiếng Việt ViVoice | Mã MIT; trọng số CC-BY-NC hoặc CC-BY-NC-SA-4.0 | Không | Cấm nhân bản giọng khi không có sự đồng ý hợp pháp |
| MMS-TTS vie (Meta) | CC-BY-NC 4.0 | Không | |
| Kokoro-82M, VibeVoice | Apache-2.0, MIT | Không có tiếng Việt; mã TTS của VibeVoice đã bị gỡ ngày 05/09/2025 |
Với VieNeu-TTS, nhà phát triển ghi chạy trên CPU (ONNX) đạt RTF khoảng 0,5 trên Core i5 thế hệ 12, nghĩa là tạo 10 giây giọng mất khoảng 5 giây (cách hiểu chỉ số RTF). Dự án có nhân bản giọng từ đoạn ghi âm 3–8 giây.
Chất lượng đọc tiếng Việt chưa có xếp hạng chính thức. Hãy lấy 5 đoạn kịch bản thật (có tên sản phẩm, giá, tiếng địa phương), tạo bằng vài giọng có sẵn của dự án dùng thương mại được, so với giọng tự đọc, nhờ vài người nghe chấm rồi mới chọn.
Nguồn: VieNeu-TTS · VieNeu-TTS v3 Turbo · Piper vais1000 · Piper lessac · Giấy phép dữ liệu Lessac · viXTTS · F5-TTS Vietnamese · MMS-TTS vie · Kokoro voices · VibeVoice
Model video mở và máy cần có
| Model | Giấy phép · thương mại | Máy theo nguồn chính thức |
|---|---|---|
| Wan 2.1 T2V-1.3B | Apache-2.0 · Có | Khoảng 8,19GB VRAM; video 5 giây 480P mất khoảng 4 phút trên RTX 4090 |
| Wan 2.2 TI2V-5B | Apache-2.0 · Có | 720P 24fps; GPU từ 24GB (ví dụ RTX 4090) khi bật offload; video 5 giây dưới 9 phút trên một GPU phổ thông |
| Wan 2.2 A14B | Apache-2.0 · Có | Một GPU cần từ 80GB VRAM |
| LTX-2, LTX-2.5 | LTX-2.x Community License · Có điều kiện | Tạo cả video lẫn âm thanh; doanh thu năm từ 10 triệu USD phải mua giấy phép; không công bố VRAM |
| HunyuanVideo 1.5 (8,3B) | Tencent Hunyuan Community License · Có điều kiện | Tối thiểu 14GB khi bật offload; không áp dụng tại EU, Anh, Hàn Quốc |
| HunyuanVideo (13B+) | Như trên | 45–60GB tuỳ độ phân giải, khuyến nghị 80GB |
- Wan 2.5, 2.6 chưa có trọng số mở: trang Wan-AI trên Hugging Face và GitHub chỉ có bản 2.1, 2.2.
- LTX-Video các bản 0.9.x cũng dùng giấy phép có ngưỡng doanh thu 10 triệu USD/năm; HunyuanVideo yêu cầu xin phép khi sản phẩm trên 100 triệu người dùng hoạt động mỗi tháng.
- Phần mềm chạy: README của ComfyUI (GPL-3.0) liệt kê Wan 2.1, 2.2, LTX-Video 2, 2.3, HunyuanVideo 1.5; Draw Things (ứng dụng miễn phí, lõi GPL-3.0) trên thiết bị Apple hỗ trợ Wan 2.2 và LTX-2.3.
Giới hạn thực tế: mỗi lần chỉ được clip vài giây, chờ tính bằng phút, kết quả cần chọn lọc. Model lớn cần GPU 45–80GB, nghĩa là thuê GPU theo giờ hoặc dùng dịch vụ đám mây. Với video bán hàng, cảnh quay thật vẫn là phần chính; AI hợp làm cảnh phụ, chuyển cảnh, minh hoạ ý tưởng.
Nguồn: Wan 2.1 · Wan 2.2 · Wan-AI · LTX-Video · LTX-2 License · HunyuanVideo · HunyuanVideo 1.5 · ComfyUI · Draw Things
Quy trình làm video ngắn có AI Local hỗ trợ
Ví dụ minh hoạ cho một video giới thiệu sản phẩm dài 30–60 giây:
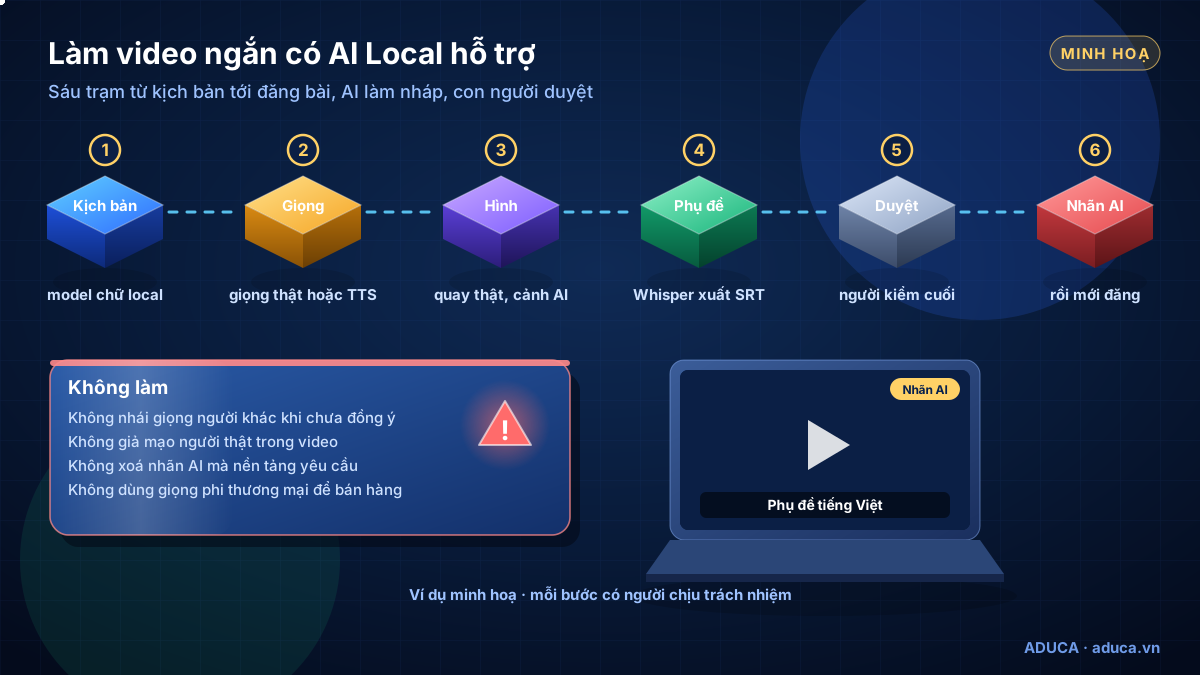
- Kịch bảnModel chữ local viết nháp, người sửa; xem AI Local viết content
- GiọngTự đọc, hoặc TTS dùng thương mại được như VieNeu-TTS v3 (Apache-2.0)
- HìnhQuay thật là chính; cảnh phụ từ ảnh AI (tạo ảnh bằng AI Local) hoặc clip ngắn
- Phụ đềWhisper xuất SRT, người đọc lại rồi đưa vào phần mềm dựng
- DuyệtNgười phụ trách xem toàn bộ: nội dung, giọng, giấy phép
- Nhãn AI, đăngKhai báo nội dung AI theo nền tảng, lưu hồ sơ công cụ đã dùng
Nhãn AI, giả mạo và những điều không làm
Luật Trí tuệ nhân tạo (Luật 134/2025/QH15) có hiệu lực từ 01/03/2026. Theo Báo Đại biểu Nhân dân, Điều 11 yêu cầu đánh dấu âm thanh, hình ảnh, video do AI tạo theo định dạng máy đọc được, thông báo rõ khi nội dung AI có thể gây nhầm lẫn về sự kiện hoặc nhân vật thật, và gắn nhãn nội dung giả lập ngoại hình, giọng nói người thật; Chính phủ quy định chi tiết. Luật cũng cấm tẩy xoá, làm sai lệch nhãn bắt buộc. Chi tiết hơn ở bài tạo ảnh.
- Meta bắt buộc tự khai với video chân thực hoặc âm thanh nghe như thật; không khai có thể bị phạt.
- TikTok bắt buộc gắn nhãn nội dung AI có hình ảnh, âm thanh, video chân thực.
- YouTube bắt buộc khai báo khi AI thay đổi đáng kể hoặc tạo nội dung trông như thật; dùng AI viết kịch bản thì không cần.
Nguồn: Báo Đại biểu Nhân dân – Điều 11 · Cổng Xây dựng chính sách – Luật Trí tuệ nhân tạo · Meta · TikTok · YouTube
Bắt đầu từ đâu?
- Phụ đề trước: cài Whisper hoặc whisper.cpp, chép lời 3 video cũ, so với phụ đề bạn đã gõ tay.
- Thử giọng đọc: chạy VieNeu-TTS v3 với 5 đoạn kịch bản thật; nếu chưa ưng thì tiếp tục tự đọc.
- Video AI để sau: thử Wan 2.1 1.3B khi card có VRAM vượt mức khoảng 8,19GB mà model cần, hoặc thuê GPU theo giờ.
Đọc tiếp: Bản đồ model AI mở 2026, 40 việc AI Local làm được, Chi phí thật và bảo mật khi dùng AI Local.
Muốn được tư vấn hoặc cài đặt AI Local theo nhu cầu riêng, bạn có thể đăng ký Tư vấn 1-1 hoặc Coaching 1-1 cho doanh nghiệp; chi phí báo sau buổi tư vấn.
Đọc tiếp: Chatbot trả lời tin nhắn →
Câu hỏi thường gặp
Whisper có chép lời tiếng Việt được không?
Có. Whisper của OpenAI có tiếng Việt (mã vi), giấy phép MIT cho cả mã và trọng số, xuất phụ đề SRT, VTT. VinAI có PhoWhisper, bản Whisper tinh chỉnh trên 844 giờ tiếng Việt, giấy phép BSD-3-Clause. Độ chính xác tuỳ chất lượng ghi âm, nên luôn đọc lại tên riêng, giá, số điện thoại trước khi đăng.
Giọng đọc tiếng Việt chạy local nào dùng thương mại được?
Theo kiểm tra 10/2026, VieNeu-TTS v3 Turbo dùng Apache-2.0 cho cả mã và trọng số. viXTTS, F5-TTS bản tiếng Việt và MMS-TTS tiếng Việt chỉ cho dùng phi thương mại. Giọng Piper vais1000 có dữ liệu CC BY 4.0 nhưng được tinh chỉnh từ một giọng tiếng Anh mà dữ liệu gốc cấm dùng thương mại, nên cần hỏi ý kiến pháp lý trước. Giấy phép có thể đổi, hãy đọc lại trang gốc trước khi dùng.
Có được nhân bản giọng của người khác không?
Chỉ dùng giọng của chính bạn hoặc của người đã đồng ý bằng văn bản. Model card F5-TTS tiếng Việt cấm nhân bản giọng khi không có sự đồng ý hợp pháp, và Luật Trí tuệ nhân tạo của Việt Nam yêu cầu gắn nhãn nội dung giả lập người thật.
Máy tính bình thường có tạo video bằng AI được không?
Model nhỏ thì có thể: Wan 2.1 bản 1.3B cần khoảng 8,19GB VRAM và mất khoảng 4 phút cho video 5 giây 480P trên RTX 4090; HunyuanVideo 1.5 cần tối thiểu 14GB khi bật offload. Model lớn như Wan 2.2 A14B cần từ 80GB VRAM, phải thuê GPU hoặc dùng dịch vụ đám mây.
Video làm bằng AI đăng lên mạng có phải ghi nhãn không?
Với video, âm thanh trông hoặc nghe như thật thì nên ghi. Meta bắt buộc tự khai với video chân thực và âm thanh nghe như thật; TikTok và YouTube cũng yêu cầu khai báo nội dung AI chân thực. Luật Trí tuệ nhân tạo của Việt Nam có hiệu lực từ 01/03/2026 yêu cầu minh bạch với nội dung AI dễ gây nhầm lẫn.
Tài liệu liên quan
- AI Local · AI AgentAI Local là gì? Chạy AI ngay trên máy tính, không tốn phí APIAI Local là gì: chạy model AI mở ngay trên máy tính của bạn, không trả phí API theo lượt, dữ liệu ở lại máy. Lợi ích, giới hạn, so sánh với AI đám mây.
- AI Local · AI AgentCấu hình máy tính chạy AI Local: RAM, VRAM, Mac hay PC NVIDIACấu hình máy tính chạy AI Local: RAM, VRAM quyết định model nào chạy được, cách ước tính dung lượng theo Q4/Q8, Mac hay PC NVIDIA, ổ cứng, mua máy hay thuê GPU.
- AI Local · AI AgentBản đồ model AI mở 2026: chọn model theo việc và theo máyBản đồ model AI mở 2026: Qwen, Gemma 4, gpt-oss, Llama 4, Mistral, GLM, DeepSeek, Phi; cỡ, MoE hay dense, giấy phép thương mại, tag Ollama, tự thử tiếng Việt.
- AI Local · AI AgentCài AI Local trong 30 phút: Ollama, LM Studio và Open WebUICài AI Local từng bước trên Windows, macOS, Linux: chọn Ollama, LM Studio, Jan hay llama.cpp, chạy thử model nhỏ, đặt context, dựng Open WebUI cho nhóm.
Xem tất cả tài liệu hướng dẫn →
Đăng ký Tư vấn 1-1 về AI Local
Chuyên gia Aduca cùng bạn xem nhu cầu, máy đang có và dữ liệu cần bảo vệ, rồi đề xuất nên chạy AI Local, dùng đám mây hay kết hợp. Dịch vụ cài AI Local nằm trong gói Tư vấn 1-1 hoặc Coaching 1-1; chi phí báo sau buổi tư vấn.
Nguồn tham khảo
- GitHub OpenAI Whisper
- GitHub whisper.cpp
- GitHub faster-whisper
- Hugging Face – PhoWhisper-large (VinAI)
- GitHub VieNeu-TTS
- Hugging Face – Piper voices vi_VN
- GitHub Wan 2.1
- GitHub HunyuanVideo 1.5
- GitHub LTX-2
- Báo Đại biểu Nhân dân – Trách nhiệm minh bạch trong Luật Trí tuệ nhân tạo
Lịch sử cập nhật
- 07/10/2026 — Bản đầu.
Miễn trừ trách nhiệm
Bài viết thuộc chuỗi kiến thức của Công ty Cổ phần Giáo dục Aduca, chia sẻ miễn phí cho mục đích học tập. Thông tin kỹ thuật đối chiếu với tài liệu chính thức của các dự án và nền tảng tại ngày cập nhật (có ghi nguồn); phần nhận định là quan điểm của Aduca. OpenClaw, Hermes Agent, Claude (thương hiệu của Anthropic), ChatGPT (thương hiệu của OpenAI), n8n (thương hiệu của n8n GmbH), các phần mềm chạy model và các model AI mở (Ollama, LM Studio, Qwen, Gemma, gpt-oss…) cùng các phần mềm, dịch vụ nêu trong bài thuộc về chủ sở hữu tương ứng, không thuộc Aduca; Aduca không phải đối tác chính thức của các công ty này. Tính năng, gói và giá có thể thay đổi bất cứ lúc nào – hãy kiểm tra trang chính thức trước khi mua. Kết quả áp dụng phụ thuộc quy trình, dữ liệu và con người của từng doanh nghiệp; bài viết không cam kết doanh thu hay hiệu quả cụ thể. © 2026 Aduca — được trích dẫn khi ghi rõ nguồn aduca.vn.