AI Local là gì? Chạy AI ngay trên máy tính, không tốn phí API
AI Local giúp bạn chạy AI ngay trên máy tính hoặc máy chủ của mình, không trả phí theo lượt và không phải gửi dữ liệu ra ngoài. Bài viết giải thích cho người mới: cần những gì, làm được gì, giới hạn ở đâu và khi nào nên kết hợp với AI đám mây. Dữ kiện tổng hợp từ tài liệu chính thức tại ngày 07/10/2026.
Hoá đơn AI tăng theo lượt dùng, dữ liệu khách nằm trên máy chủ người khác
Anh Tuấn làm chủ một văn phòng dịch vụ kế toán nhỏ. Cả đội đã quen nhờ trợ lý AI tóm tắt hợp đồng, soạn email, đối chiếu chứng từ. Nhưng mỗi lần dán báo cáo tài chính của khách vào khung chat, anh lại băn khoăn: dữ liệu này đang đi đâu? Khi đội kỹ thuật gắn AI vào phần mềm nội bộ qua API, hoá đơn lại tăng theo số lượt dùng, tháng nhiều việc thì trả nhiều. (Tình huống minh hoạ.)
AI Local là một hướng trả lời cho cả hai băn khoăn đó: đưa "bộ não" AI về chạy ngay trên máy của bạn. Nó không thay được mọi thứ, nhưng với nhiều việc thường ngày, đây là lựa chọn đáng cân nhắc.
AI Local là gì?
AI Local là cách chạy một model AI mở (open-weight) ngay trên máy tính hoặc máy chủ của bạn: không trả phí API theo lượt dùng, và dữ liệu không phải gửi lên máy chủ của hãng AI.
Đây là định nghĩa làm việc mà Aduca tổng hợp từ tài liệu các công cụ chạy model, không phải định nghĩa riêng của một hãng nào. Đổi lại cho hai lợi ích trên, bạn trả tiền máy, tiền điện và công cài đặt, vận hành.
Trong ẩn dụ "nhân viên số" mà thư viện Aduca dùng xuyên suốt, model là bộ não. AI Local chỉ quyết định bộ não đó đặt ở đâu: trên máy của bạn thay vì trên máy chủ của hãng. Muốn bộ não ấy có thêm đôi tay (công cụ), điện thoại (kênh chat) và lịch làm việc, bạn nối nó với các hệ thống như OpenClaw, Hermes hay n8n (xem phần kết hợp ở cuối bài).
Model mở và model đóng qua API khác nhau thế nào?
Model mở (open-weight) là model mà hãng công bố file trọng số để người dùng tải về và tự chạy. Chính các hãng dùng cách gọi này: OpenAI gọi gpt-oss là model "open-weight", Google ghi bản Gemma 4 gồm các model "open-weights".
Model đóng qua API như Claude của Anthropic hay GPT của OpenAI chạy trên máy chủ của hãng. Bạn gửi dữ liệu lên, nhận kết quả về và trả tiền theo token (đơn vị chữ mà model đọc và viết). Ví dụ bảng giá API của Claude tính theo triệu token, tách riêng phần đầu vào và phần đầu ra.
| Model mở chạy local | Model đóng qua API | |
|---|---|---|
| Chạy ở đâu | Máy tính hoặc máy chủ của bạn | Máy chủ của hãng |
| Cách trả tiền | Không phí theo lượt; trả tiền máy, điện, công vận hành | Theo token đầu vào và đầu ra |
| Dữ liệu | Ở lại trên máy, trừ khi bạn tự nối dịch vụ đám mây | Gửi lên máy chủ của hãng |
| Ví dụ | Qwen, Gemma 4, gpt-oss, Llama 4, Mistral, GLM, DeepSeek, Phi | Claude, GPT |
Bản đồ các họ model, cỡ, giấy phép và máy phù hợp: Bản đồ model AI mở 2026.
Nguồn: gpt-oss-20b · Gemma 4 · Claude pricing · Llama 4 License · Qwen3.8-Flash-Next
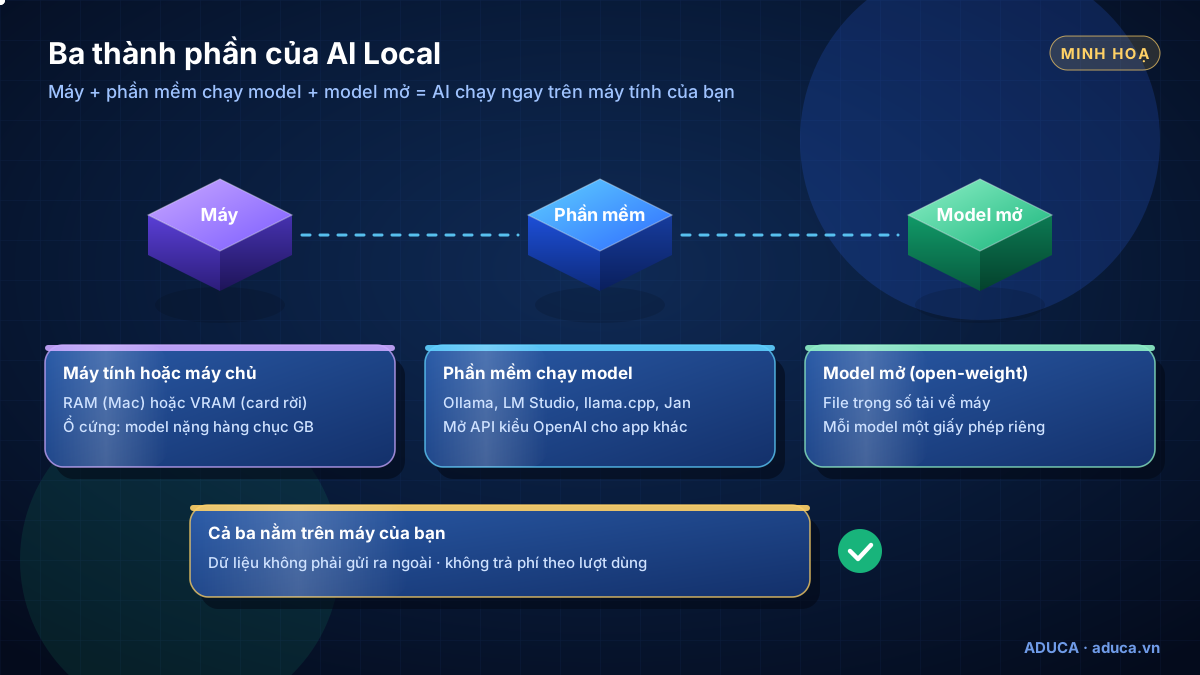
Ba thành phần của AI Local: máy, phần mềm chạy model và model
1. Máy: bộ nhớ quyết định model nào chạy được
Model phải được nạp vào bộ nhớ mới chạy được. Trên PC có card đồ hoạ NVIDIA, chỗ chứa chính là VRAM (bộ nhớ riêng của card), ví dụ RTX 4090 có 24GB, RTX 5090 có 32GB. Trên Mac chip Apple Silicon, CPU và GPU dùng chung một khối bộ nhớ hợp nhất, nên Mac nhiều RAM có thể nạp model lớn hơn một card rời ít VRAM. Máy chỉ có CPU vẫn chạy được model nhỏ bằng llama.cpp, chỉ chậm hơn.
Cách ước tính nhanh (ước tính, tính từ bảng dung lượng của llama.cpp): ở mức nén phổ biến Q4_K_M, mỗi 1 tỷ tham số cần khoảng 0,61 GB; bản 8 bit (Q8_0) khoảng 1,06 GB; bản gốc 16 bit khoảng 2 GB. Ví dụ llama.cpp ghi Llama 3.1 8B ở Q4_K_M nặng khoảng 4,9 GB, bản 70B khoảng 43,1 GB. Cần cộng thêm bộ nhớ cho phần ngữ cảnh (context, lượng chữ model giữ trong đầu một lúc) và cho hệ điều hành. Chi tiết theo từng mức máy: Cấu hình máy tính chạy AI Local.
2. Phần mềm chạy model: "động cơ" nạp và phục vụ model
- Ollama: miễn phí, giấy phép MIT; chạy trên macOS 14 trở lên, Windows 10 22H2 trở lên và Linux; dùng bằng dòng lệnh hoặc app, có sẵn thư viện model.
- LM Studio: app có giao diện, hợp người không làm kỹ thuật; miễn phí cả khi dùng cho công việc từ 08/07/2025; điều khoản cho dùng cho mục đích cá nhân và nội bộ doanh nghiệp, cấm bán lại.
- llama.cpp: "động cơ" giấy phép MIT chạy được trên gần như mọi phần cứng, kể cả máy chỉ có CPU; nhiều tham số, hợp người kỹ thuật.
- Jan: app desktop giấy phép Apache-2.0 cho Windows, macOS, Linux.
- Open WebUI: không tự chạy model mà là giao diện chat trên trình duyệt để cả nhóm dùng chung model local; giấy phép riêng, có điều khoản giữ thương hiệu khi hệ thống trên 50 người dùng.
Điểm chung đáng giá: Ollama, LM Studio, llama.cpp và Jan đều mở một API tương thích OpenAI ngay trên máy (ví dụ Ollama ở http://localhost:11434/v1). Nhiều phần mềm viết cho OpenAI chỉ cần đổi địa chỉ là dùng được model local. Cách cài từng bước: Cài AI Local trong 30 phút: Ollama, LM Studio và Open WebUI.
3. Model: file trọng số bạn tải về
Model là một file lớn tải từ thư viện của Ollama, LM Studio hoặc Hugging Face. Ví dụ theo trang thư viện Ollama: qwen3.5:4b nặng 3,3–4,0 GB; gpt-oss:20b nặng 14 GB (model card ghi chạy được trong khoảng 16GB bộ nhớ); gpt-oss:120b nặng 65 GB. Model càng lớn thường càng giỏi việc khó, nhưng càng cần máy mạnh. Lần tải đầu cần Internet, sau đó chạy offline được.
Nguồn: llama.cpp quantize · NVIDIA – so sánh card · Apple – unified memory · Ollama macOS · Ollama Windows · LM Studio free for work · LM Studio terms · Jan · Open WebUI license · Ollama OpenAI compatibility · Ollama qwen3.5 · Ollama gpt-oss
Lợi ích: không phí theo lượt, dữ liệu ở lại máy, chạy offline
- Không trả phí theo token cho model chạy local. Ollama, llama.cpp, Jan là phần mềm miễn phí; LM Studio miễn phí cả khi dùng cho công việc. Giúp bạn dùng nhiều, thử nhiều mà không lo hoá đơn tăng theo lượt, hợp với việc lặp lại số lượng lớn như phân loại, tóm tắt.
- Dữ liệu ở lại trên máy. Tài liệu Ollama ghi rõ khi chạy local, họ không thấy prompt hay dữ liệu của bạn. Giúp bạn xử lý hợp đồng, báo giá, dữ liệu khách mà không gửi lên máy chủ bên ngoài.
- Chạy được khi không có mạng. Tài liệu LM Studio ghi việc chat và xử lý tài liệu diễn ra hoàn toàn trên máy; chỉ cần mạng khi tải model, runtime hoặc cập nhật. Giúp bạn làm việc ổn định khi mạng chập chờn, hoặc trên máy cố ý tách khỏi Internet.
- Dùng chung với phần mềm sẵn có nhờ API tương thích OpenAI. Giúp bạn nối model local vào n8n, OpenClaw, Hermes hay công cụ lập trình mà không phải viết lại từ đầu.
-cloud trong Ollama (ví dụ gpt-oss:120b-cloud) chạy trên máy chủ của Ollama, tức dữ liệu đã rời máy. Tính năng tìm web, hoặc khi bạn nối Jan, AnythingLLM, Open WebUI với API đám mây, cũng vậy. Muốn tắt hẳn phần đám mây của Ollama, đặt biến môi trường OLLAMA_NO_CLOUD=1.Nguồn: Ollama FAQ · Ollama Cloud · LM Studio offline · llama.cpp · Ollama OpenAI compatibility
Giới hạn của AI Local cần nói thẳng
- Bị giới hạn bởi bộ nhớ máy. Model không vừa VRAM thì Ollama phải chia một phần sang CPU (lệnh
ollama pshiện tỷ lệ kiểu "48%/52% CPU/GPU") và chạy chậm hẳn. - Ngữ cảnh mặc định ngắn trên máy phổ thông. Ollama tự đặt độ dài ngữ cảnh 4k token khi VRAM dưới 24 GiB, 32k token ở mức 24–48 GiB. Việc đọc tài liệu dài hay làm agent phải tự tăng lên, và tăng thì tốn thêm bộ nhớ.
- Model mở lớn nhất vẫn quá cỡ máy cá nhân. Ví dụ DeepSeek-V4.1-Flash có 552 tỷ tham số phần lõi, GLM-5.3-Flash có 320 tỷ tham số tổng; muốn chạy cần máy chủ nhiều GPU.
- Chất lượng ở việc khó. Model mở chạy vừa máy phổ thông thường chưa bằng model lớn nhất trên đám mây ở việc như phân tích nhiều bước hay viết bán hàng tinh tế. Hiện chưa có bảng xếp hạng tiếng Việt chính thức cho các model mở; cách đáng tin nhất là tự thử bằng bộ câu hỏi thật của doanh nghiệp.
- Không có bộ lọc an toàn của nhà cung cấp. Tài liệu OpenClaw lưu ý model local không có các lớp lọc an toàn như dịch vụ đám mây, và khuyên không dùng model nhỏ, yếu cho agent có công cụ hoặc hộp thư nhận tin người lạ.
- Tự lo bảo mật và cập nhật. Phần mềm chạy model cũng có lỗ hổng, ví dụ Ollama từng có lỗ hổng mức nghiêm trọng CVE-2026-7482, đã vá ở bản 0.17.1. Cập nhật, sao lưu, theo dõi là việc của bạn.
- Tốn công cài đặt và vận hành, nhất là khi cả nhóm dùng chung một máy.
Cách tính chi phí thật và các bước bảo mật: Chi phí thật và bảo mật khi dùng AI Local.
Nguồn: Ollama FAQ · Ollama context length · DeepSeek-V4.1-Flash · GLM-5.3-Flash · OpenClaw – Local models · OpenClaw – Prompt injection · CVE-2026-7482
AI Local làm được gì cho kinh doanh?
Dưới đây là các nhóm việc chính, mỗi nhóm có bài riêng trong thư viện. Với model tạo ảnh, video, giọng nói, giấy phép khác nhau rất nhiều, nên mỗi bài đều ghi rõ model nào dùng thương mại được.
| Nhóm việc | Ví dụ | Đọc chi tiết |
|---|---|---|
| Viết content | Bài đăng, caption, kịch bản, email nháp theo giọng thương hiệu | AI Local viết content |
| Tạo ảnh | Ảnh sản phẩm, ảnh quảng cáo bằng ComfyUI (GPL-3.0) hoặc Draw Things (lõi GPL-3.0, chỉ trên thiết bị Apple). Ví dụ FLUX.1 [schnell] giấy phép Apache-2.0, dùng thương mại được; FLUX.1 [dev] chỉ được chạy cho mục đích phi thương mại | Tạo ảnh bằng AI Local |
| Video và giọng nói | Chép lời, làm phụ đề tiếng Việt bằng Whisper (giấy phép MIT, dùng thương mại được); đọc giọng và video ngắn tuỳ giấy phép từng model | AI Local cho video và giọng nói |
| Chatbot trả lời tin nhắn | Trả lời câu hỏi sản phẩm từ kho kiến thức, người duyệt câu khó | Chatbot bán hàng chạy AI Local |
| Slide, tài liệu, Excel | Hỏi đáp tài liệu nội bộ, tóm tắt PDF, Word, phân tích bảng dữ liệu | AI Local làm slide, tài liệu, Excel |
| Lập trình | Trợ lý code chạy trên máy trong trình soạn code | AI Local cho lập trình |
| Bộ não cho AI Agent | Làm model cho OpenClaw, Hermes, n8n | Dùng AI Local làm bộ não cho AI Agent |
Danh sách đầy đủ hơn, chia theo Marketing, Sales, vận hành và code: 40 việc AI Local làm được cho doanh nghiệp.
Nguồn: FLUX.1 [schnell] · FLUX.1 [dev] · OpenAI Whisper
AI Local và AI đám mây: bảng so sánh khách quan
Bảng dưới không chấm bên nào hơn; mỗi bên phù hợp với một kiểu việc.
| Tiêu chí | AI Local | AI đám mây (Claude, ChatGPT) |
|---|---|---|
| Chi phí | Trả trước tiền máy, cộng điện và công vận hành; không phí theo lượt | Trả theo token (API) hoặc theo gói; ví dụ API Claude Haiku 4.5 giá $1 cho 1 triệu token đầu vào, $5 cho 1 triệu token đầu ra (10/2026, có thể thay đổi) |
| Dữ liệu | Ở lại trên máy | Gửi lên máy chủ hãng, theo chính sách dữ liệu của từng gói |
| Chất lượng ở việc khó | Tuỳ model vừa máy; model nhỏ dễ sai ở việc nhiều bước | Có các model lớn nhất của hãng |
| Độ dài ngữ cảnh | Tuỳ bộ nhớ; Ollama mặc định 4k token khi VRAM dưới 24 GiB | Ví dụ Claude Sonnet 5.5 có ngữ cảnh 1 triệu token |
| Tốc độ | Tuỳ máy; tràn bộ nhớ thì chậm hẳn | Tuỳ hạ tầng và gói của hãng |
| Chạy offline | Được, sau khi đã tải model | Không |
| Cài đặt, vận hành | Bạn tự cài, cập nhật, sao lưu | Hãng lo hạ tầng; bạn quản lý tài khoản, khoá API |
| Bảo mật | Tự lo: không mở cổng ra Internet, cập nhật bản vá | Hãng lo máy chủ; bạn lo khoá API và dữ liệu đưa lên |
| Bộ lọc an toàn | Không có lớp lọc của nhà cung cấp | Có lớp lọc của nhà cung cấp |
| Nhiều người dùng cùng lúc | Cần máy mạnh hơn hoặc phần mềm máy chủ như vLLM | Mở rộng theo gói hoặc hạn mức |
Công thức so tiền cụ thể: Chi phí thật và bảo mật khi dùng AI Local.
Nguồn: Claude pricing · Claude models overview · Ollama context length · OpenClaw – Local models · vLLM
Khi nào nên dùng AI Local, khi nào dùng đám mây?
Thông điệp xuyên suốt của thư mục này: việc thường ngày, dữ liệu nhạy cảm dùng AI Local; việc khó, cần chất lượng cao nhất dùng đám mây; kết hợp cả hai là thực tế nhất.
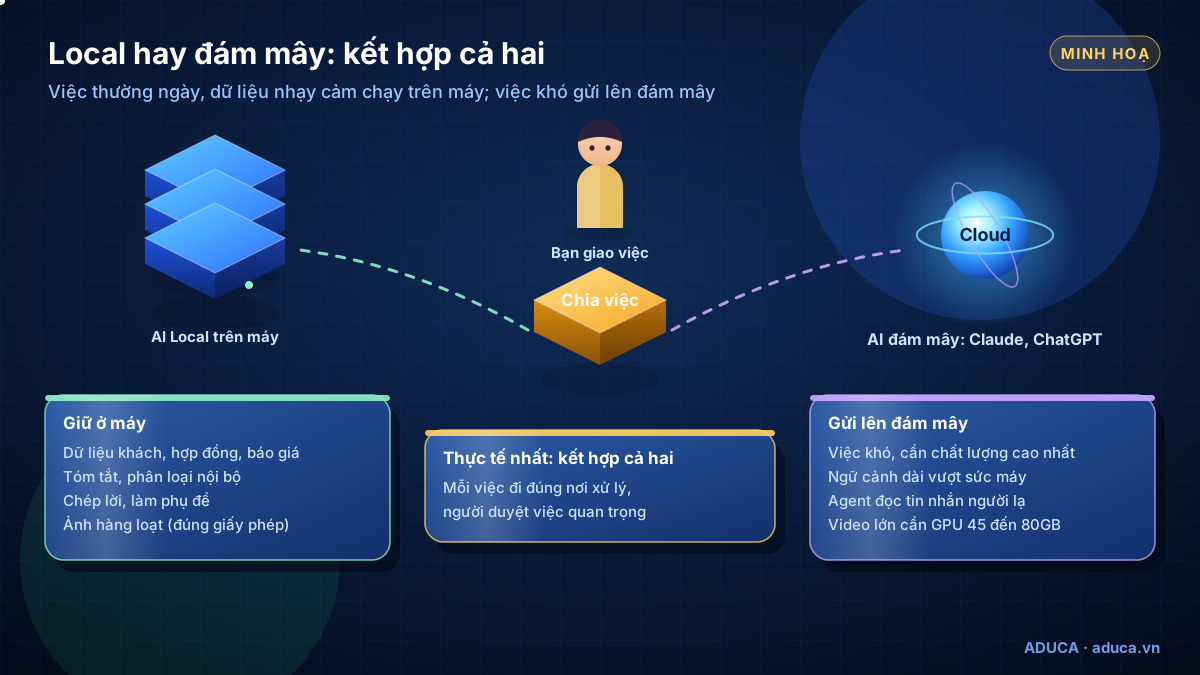
Nên ưu tiên AI Local khi
- Dữ liệu nhạy cảm: hợp đồng, dữ liệu khách hàng, số liệu tài chính.
- Việc lặp lại số lượng lớn: phân loại, tóm tắt nội bộ, trích thông tin từ văn bản.
- Chép lời cuộc họp, làm phụ đề video.
- Tạo ảnh hàng loạt bằng model có giấy phép cho phép dùng thương mại.
- Nơi làm việc mạng không ổn định.
Nên dùng đám mây khi
- Agent có công cụ hoặc phải đọc tin nhắn của người lạ: tài liệu OpenClaw khuyên không dùng model nhỏ, yếu cho trường hợp này.
- Cần ngữ cảnh dài mà máy không đủ bộ nhớ: ví dụ Hermes yêu cầu tối thiểu 64.000 token ngữ cảnh khi dùng làm agent.
- Video cỡ lớn cần GPU 45–80GB, như HunyuanVideo bản gốc (giấy phép riêng, có điều kiện) hay Wan 2.2 A14B (Apache-2.0).
- Văn phong bán hàng tinh tế khi bạn chưa tự kiểm chứng chất lượng tiếng Việt của model local.
Kết hợp: model local làm chính, đám mây làm dự phòng
Các công cụ trong thư viện Aduca đều đi được theo hướng này. Claude và ChatGPT là trợ lý đám mây cho việc khó. OpenClaw, Hermes và n8n có thể dùng model local làm bộ não: OpenClaw có chế độ models.mode: "merge" giữ model đám mây làm dự phòng; Hermes nhận model local qua mục "Custom endpoint"; n8n có node Ollama Chat Model cho AI Agent trong n8n. Cấu hình, định tuyến local với đám mây và nối máy local với VPS an toàn: Dùng AI Local làm bộ não cho OpenClaw, Hermes, n8n. Giới thiệu từng công cụ: OpenClaw là gì, Hermes Agent là gì, n8n là gì; so sánh để chọn: Chọn công cụ AI Agent.
Nguồn: OpenClaw – Local models · OpenClaw – Prompt injection · Hermes – Providers · n8n – Ollama Chat Model · HunyuanVideo · Wan 2.2
Bắt đầu với AI Local từ đâu?
- Kiểm tra máy bạn đang có: bao nhiêu RAM, có card đồ hoạ rời không, VRAM bao nhiêu, ổ cứng còn trống bao nhiêu. Đối chiếu với Cấu hình máy tính chạy AI Local.
- Chọn một model nhỏ, hợp máy, có giấy phép rõ ràng, ví dụ một model Apache-2.0 nặng vài GB cho máy 8–16GB (ví dụ minh hoạ). Xem Bản đồ model AI mở 2026.
- Cài Ollama hoặc LM Studio, thử với 10–20 câu hỏi thật của doanh nghiệp: email khách, mô tả sản phẩm, tài liệu nội bộ. Ghi lại chỗ đạt và chưa đạt, so với trợ lý đám mây bạn đang dùng. Xem Cài AI Local trong 30 phút.
127.0.0.1:11434), không mở cổng ra Internet; cần dùng từ xa thì đi qua VPN hoặc reverse proxy có xác thực. Khoá, token chỉ đặt trong biến môi trường hoặc tệp .env trên máy, không gửi qua chat, không dán vào prompt.Khi đã quen, đọc tiếp Chi phí thật và bảo mật khi dùng AI Local và Lộ trình xây hệ thống AI Local cho doanh nghiệp (từ một máy đến cả đội).
Muốn được tư vấn hoặc cài đặt AI Local theo nhu cầu riêng, bạn có thể đăng ký Tư vấn 1-1 hoặc Coaching 1-1 cho doanh nghiệp; chi phí báo sau buổi tư vấn.
Nguồn: Ollama FAQ
Đọc tiếp: Cấu hình máy →
Câu hỏi thường gặp
AI Local là gì, nói ngắn gọn?
AI Local là chạy một model AI mở ngay trên máy tính hoặc máy chủ của bạn, bằng phần mềm như Ollama, LM Studio hay llama.cpp. Bạn không trả phí API theo lượt dùng và dữ liệu không phải gửi lên máy chủ của hãng AI. Đổi lại, bạn cần máy đủ bộ nhớ và tự lo cài đặt, cập nhật, bảo mật.
AI Local có thật sự miễn phí không?
Phần mềm chạy model như Ollama, llama.cpp, Jan miễn phí, LM Studio miễn phí cả khi dùng cho công việc, và không có phí theo token. Nhưng bạn vẫn trả tiền máy, tiền điện và thời gian vận hành. Cách tự tính và so với hoá đơn API có ở bài Chi phí thật và bảo mật khi dùng AI Local.
Máy tính bình thường có chạy được AI Local không?
Được với model nhỏ. LM Studio khuyên máy từ 16GB RAM, máy 8GB chỉ chạy được model nhỏ; README của Jan ghi khoảng 8GB RAM cho model 3B. Máy chỉ có CPU vẫn chạy được model nhỏ bằng llama.cpp, nhưng chậm hơn máy có card đồ hoạ hoặc Mac Apple Silicon. Model càng lớn càng cần nhiều RAM hoặc VRAM.
AI Local có thay được Claude hay ChatGPT không?
Không hoàn toàn. Model mở chạy vừa máy phổ thông thường chưa bằng model lớn nhất trên đám mây ở việc khó. Cách thực tế là kết hợp: việc thường ngày và dữ liệu nhạy cảm chạy local, việc khó cần chất lượng cao nhất gửi lên đám mây.
Dữ liệu có thật sự không rời khỏi máy?
Khi chạy model local thì có: tài liệu Ollama ghi họ không thấy prompt hay dữ liệu của bạn. Ngoại lệ là các model có đuôi -cloud của Ollama, tính năng tìm web, hoặc khi bạn nối app với API đám mây. Ngoài ra, đừng mở cổng của phần mềm chạy model ra Internet.
Dùng model mở cho kinh doanh có cần xin phép không?
Tuỳ giấy phép của từng model. Nhóm Apache-2.0 và MIT (ví dụ Gemma 4, gpt-oss, Qwen3.5, GLM, DeepSeek) cho dùng thương mại. Llama 4 dùng giấy phép riêng có điều kiện, một số model ảnh và video chỉ cho dùng phi thương mại. Luôn đọc điều khoản trên trang model trước khi dùng.
Tài liệu liên quan
- AI Local · AI AgentCấu hình máy tính chạy AI Local: RAM, VRAM, Mac hay PC NVIDIACấu hình máy tính chạy AI Local: RAM, VRAM quyết định model nào chạy được, cách ước tính dung lượng theo Q4/Q8, Mac hay PC NVIDIA, ổ cứng, mua máy hay thuê GPU.
- AI Local · AI AgentBản đồ model AI mở 2026: chọn model theo việc và theo máyBản đồ model AI mở 2026: Qwen, Gemma 4, gpt-oss, Llama 4, Mistral, GLM, DeepSeek, Phi; cỡ, MoE hay dense, giấy phép thương mại, tag Ollama, tự thử tiếng Việt.
- AI Local · AI AgentCài AI Local trong 30 phút: Ollama, LM Studio và Open WebUICài AI Local từng bước trên Windows, macOS, Linux: chọn Ollama, LM Studio, Jan hay llama.cpp, chạy thử model nhỏ, đặt context, dựng Open WebUI cho nhóm.
- AI Local · AI AgentAI Local viết content: bài đăng, caption, kịch bản, emailAI Local viết content trên máy: chọn model mở theo giấy phép, prompt hệ thống giữ giọng thương hiệu, mẫu lệnh caption, kịch bản, email, quy trình duyệt.
Xem tất cả tài liệu hướng dẫn →
Đăng ký Tư vấn 1-1 về AI Local
Chuyên gia Aduca cùng bạn xem nhu cầu, máy đang có và dữ liệu cần bảo vệ, rồi đề xuất nên chạy AI Local, dùng đám mây hay kết hợp. Dịch vụ cài AI Local nằm trong gói Tư vấn 1-1 hoặc Coaching 1-1; chi phí báo sau buổi tư vấn.
Nguồn tham khảo
- Ollama Docs – FAQ (dữ liệu, cổng mặc định, chia CPU/GPU)
- GitHub ollama/ollama (giấy phép MIT)
- LM Studio – miễn phí cho công việc
- GitHub ggml-org/llama.cpp
- llama.cpp – bảng dung lượng theo mức nén
- Hugging Face – model card gpt-oss-20b
- Hugging Face – model card Gemma 4
- Meta – Llama 4 Community License
- Claude Docs – bảng giá API
- OpenClaw Docs – Local models
Lịch sử cập nhật
- 07/10/2026 — Bản đầu.
Miễn trừ trách nhiệm
Bài viết thuộc chuỗi kiến thức của Công ty Cổ phần Giáo dục Aduca, chia sẻ miễn phí cho mục đích học tập. Thông tin kỹ thuật đối chiếu với tài liệu chính thức của các dự án và nền tảng tại ngày cập nhật (có ghi nguồn); phần nhận định là quan điểm của Aduca. OpenClaw, Hermes Agent, Claude (thương hiệu của Anthropic), ChatGPT (thương hiệu của OpenAI), n8n (thương hiệu của n8n GmbH), các phần mềm chạy model và các model AI mở (Ollama, LM Studio, Qwen, Gemma, gpt-oss…) cùng các phần mềm, dịch vụ nêu trong bài thuộc về chủ sở hữu tương ứng, không thuộc Aduca; Aduca không phải đối tác chính thức của các công ty này. Tính năng, gói và giá có thể thay đổi bất cứ lúc nào – hãy kiểm tra trang chính thức trước khi mua. Kết quả áp dụng phụ thuộc quy trình, dữ liệu và con người của từng doanh nghiệp; bài viết không cam kết doanh thu hay hiệu quả cụ thể. © 2026 Aduca — được trích dẫn khi ghi rõ nguồn aduca.vn.