40 việc AI Local làm được cho doanh nghiệp: Marketing, Sales, vận hành, code
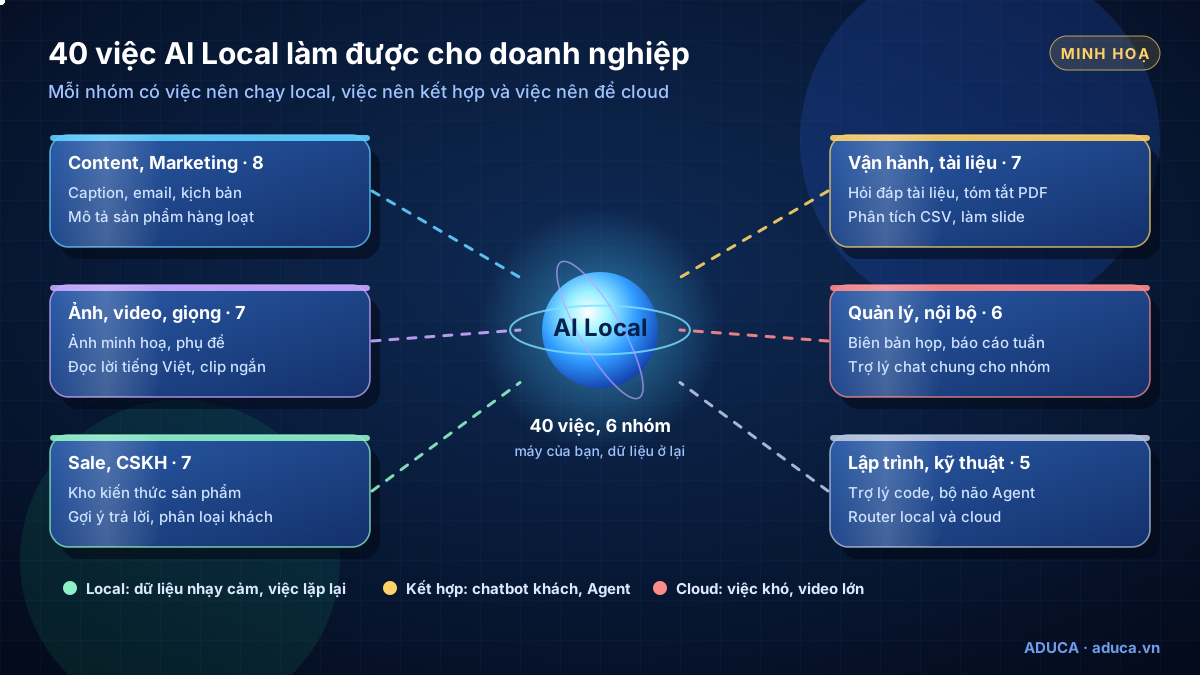
Bốn mươi việc cụ thể chia sáu nhóm: content, ảnh – video – giọng, sale – CSKH, vận hành – tài liệu, quản lý nội bộ và lập trình. Mỗi việc có công cụ, loại model, mức máy tối thiểu (ước tính) và lời khuyên nên chạy trên máy, dùng đám mây hay kết hợp, theo dữ kiện kiểm tra ngày 07/10/2026.
Cài xong Ollama rồi, giao cho nó việc gì?
Một chủ shop thời trang vừa cài Ollama, chạy thử một model và thấy nó trả lời được tiếng Việt. Câu hỏi tiếp theo khó hơn: việc nào trong công ty nên giao cho AI chạy trên máy, việc nào máy mình không kham nổi, việc nào nên để Claude hay ChatGPT làm. (Tình huống minh hoạ.)
Bài này là bộ mẫu tra cứu nhanh cho câu hỏi đó. Chưa rõ khái niệm thì đọc trước AI Local là gì.
AI Local làm được gì cho doanh nghiệp?
AI Local làm được phần lớn việc chữ thường ngày (viết nháp, tóm tắt, phân loại, hỏi đáp tài liệu), chép lời, đọc giọng và tạo ảnh ngay trên máy của doanh nghiệp; việc khó, cần chất lượng cao nhất hoặc cần GPU rất lớn thì nên kết hợp với đám mây.
Lợi ích chính: không trả phí theo lượt dùng cho model chạy trên máy, và dữ liệu không rời máy. Tài liệu của Ollama ghi rõ khi chạy local, họ không thấy câu lệnh hay dữ liệu của bạn. Ngoại lệ cần nhớ: model có đuôi -cloud của Ollama chạy trên máy chủ của họ, tức dữ liệu đã rời máy; muốn tắt hẳn thì đặt OLLAMA_NO_CLOUD=1.
Nguồn: Ollama FAQ · Ollama Cloud
Cách đọc bảng: mức máy, loại model, local hay cloud
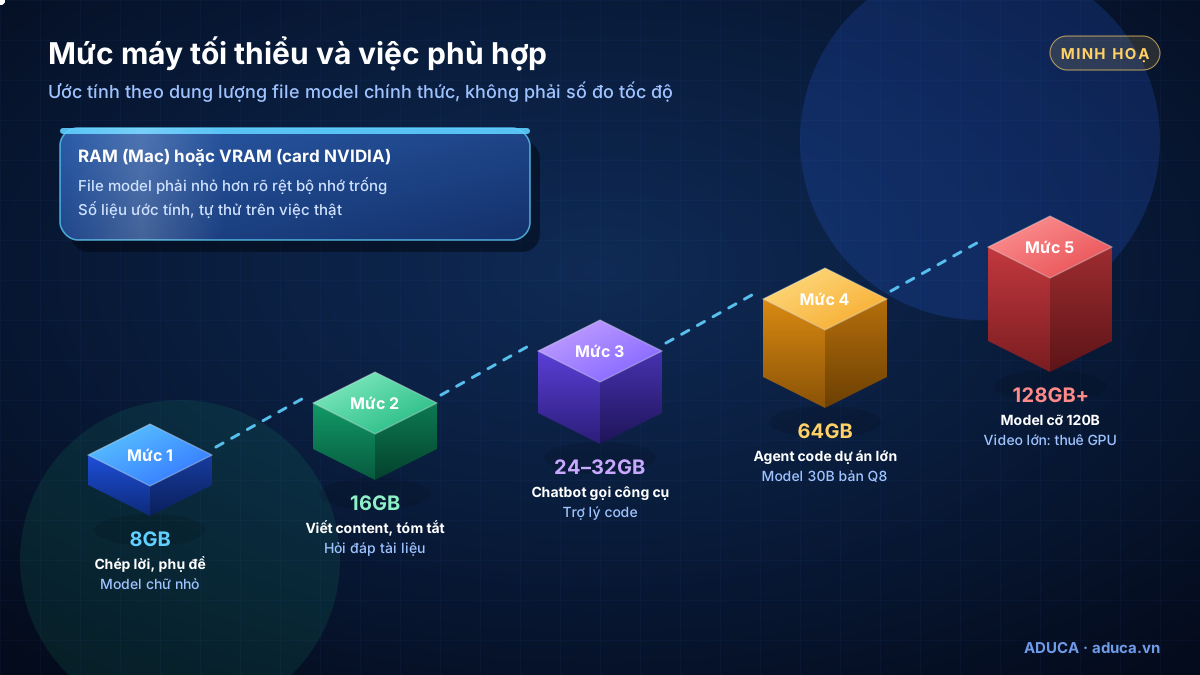
Mức máy là ước tính của Aduca, ghép từ dung lượng file model chính thức trên Ollama: file phải nhỏ hơn rõ rệt so với RAM (Mac) hoặc VRAM (card NVIDIA) để còn chỗ cho context. Đây không phải số đo tốc độ.
| Mức máy | Bộ nhớ | Ví dụ model vừa (dung lượng file) |
|---|---|---|
| Mức 1 | 8GB RAM hoặc card 8GB VRAM | qwen3.5:4b (3,3–4,0GB), gemma4:e2b bản qat (4,3GB) |
| Mức 2 | 16GB RAM hoặc card 12–16GB | qwen3.5:9b (6,6–7,6GB), gemma4:12b (7,7–8,0GB), gpt-oss:20b (14GB, cần 16GB trống) |
| Mức 3 | Mac 24–36GB hoặc card 24–32GB | gemma4:26b (16–19GB), qwen3.8:27b (18GB), qwen3.6:35b (23–24GB, sát card 24GB) |
| Mức 4 | 64GB | Bản Q8 của model khoảng 30B, qwen3-coder-next bản q4 (52GB, sát) |
| Mức 5 | 128GB trở lên | gpt-oss:120b (65GB), qwen3.5:122b (81GB) |
| Loại model | Ví dụ | Giấy phép |
|---|---|---|
| Chữ nhỏ | qwen3.5:4b, gemma4:e2b (bản qat), ministral-3:3b | Apache-2.0 |
| Chữ vừa | qwen3.5:9b, gemma4:12b, ministral-3:14b, gpt-oss:20b | Apache-2.0 |
| Chữ lớn | gemma4:26b, qwen3.8:27b, qwen3.6:35b; glm-4.7-flash | Apache-2.0; GLM: MIT |
| Nhìn hình | qwen3.8 (ảnh và video), gemma4, qwen3.5 | Apache-2.0 |
| Code | devstral:24b, qwen3-coder:30b, qwen3-coder-next | Apache-2.0 |
| Nhúng (cho kho kiến thức) | qwen3-embedding, embeddinggemma-2; bge-m3 | Apache-2.0; bge-m3: MIT |
- Local: chạy hẳn trên máy; hợp dữ liệu nhạy cảm và việc lặp lại số lượng lớn.
- Kết hợp: local làm phần chính, đám mây (Claude, ChatGPT) làm câu khó hoặc dự phòng.
- Cloud: máy phổ thông không kham nổi, hoặc cần chất lượng cao nhất.
*Cột "Máy tối thiểu" trong sáu bảng dưới là ước tính theo bảng mức máy này; với ảnh, video, giọng thì ghi theo tài liệu chính thức của công cụ hoặc model. Máy thật còn tuỳ độ dài context và số người dùng cùng lúc.
Nguồn: Ollama qwen3.5 · Ollama gemma4 · llama.cpp quantize · Ollama context length · Open WebUI RAG · Qwen3.6 model card · GLM-4.7-Flash · Phi-4-mini · qwen3-embedding
Nhóm 1. Content và Marketing (8 việc)
| Việc | Công cụ | Model gợi ý | Máy tối thiểu* | Nên |
|---|---|---|---|---|
| 1. Caption, bài đăng đúng giọng thương hiệu | Ollama (Modelfile có SYSTEM), LM Studio (preset) | Chữ vừa | Mức 2 | Local |
| 2. Viết lại một bài thành bản Facebook, email, tin nhắn | Open WebUI (Prompts có biến) | Chữ vừa | Mức 2 | Local |
| 3. Kịch bản video ngắn: dàn ý, lời thoại | Open WebUI, LM Studio | Chữ vừa hoặc lớn | Mức 2 | Kết hợp: bản quan trọng nhờ cloud góp ý |
| 4. Email chăm sóc, bản tin nháp | Ollama, Open WebUI | Chữ vừa | Mức 2 | Local |
| 5. Ý tưởng và lịch nội dung tháng | Open WebUI | Chữ lớn | Mức 3 | Kết hợp |
| 6. Mô tả sản phẩm hàng loạt từ bảng thông số | n8n (node Ollama Chat Model) | Chữ vừa | Mức 2 | Local: số lượng lớn, không tính phí theo lượt |
| 7. Rà bài trước khi đăng: chính tả, từ dễ vi phạm chính sách quảng cáo | Open WebUI (Prompts) | Chữ vừa | Mức 2 | Local, người duyệt quyết định |
| 8. Bài dài cần tìm thông tin mới trên web | Claude, ChatGPT | Model đám mây | Không cần máy mạnh | Cloud hoặc kết hợp |
Việc 1–7 là thế mạnh của AI Local: viết nháp nhiều, lặp lại, có thông tin nội bộ. Prompt hệ thống (lệnh SYSTEM trong Modelfile, preset của LM Studio) giữ giọng văn cố định. Việc 8 cần tìm web; Ollama khuyên việc tìm web đặt context từ 64.000 token. Bài đăng công khai vẫn cần người duyệt. Chi tiết: AI Local viết content.
Nguồn: Ollama Modelfile · LM Studio presets · Open WebUI Prompts · n8n Ollama Chat Model
Nhóm 2. Ảnh, video và giọng nói (7 việc)
| Việc | Công cụ | Model gợi ý | Máy tối thiểu* | Nên |
|---|---|---|---|---|
| 9. Ảnh minh hoạ, ảnh nền bài đăng | InvokeAI, Draw Things (Mac, iPhone) | Z-Image-Turbo (Apache-2.0, thương mại được) | Card 8GB VRAM, RAM 16GB (theo InvokeAI) | Local |
| 10. Ảnh bố cục phức tạp, nhiều phong cách | InvokeAI, Draw Things | FLUX.2 [klein] 4B (Apache-2.0, thương mại được) | Model card: khoảng 13GB VRAM (RTX 3090/4070 trở lên); InvokeAI ghi tối thiểu 12GB | Local |
| 11. Banner có chữ tiếng Việt | InvokeAI tạo nền, phần mềm thiết kế chèn chữ | SDXL (CreativeML Open RAIL++-M, thương mại được, có danh sách hành vi cấm) | Card 8GB VRAM, RAM 16GB (theo InvokeAI) | Local; chữ đặt bằng tay |
| 12. Sửa ảnh sản phẩm, đổi bối cảnh | Forge Neo, Draw Things | Dòng Qwen-Image (Apache-2.0); riêng Qwen-Image-2.1 chỉ phi thương mại | Chưa có số chính thức; thử trên GPU thuê trước | Kết hợp |
| 13. Chép lời video, làm phụ đề SRT | whisper.cpp, faster-whisper | Whisper (MIT) hoặc PhoWhisper (BSD-3-Clause, giữ ghi công) | Mức 1: bản large cần khoảng 3,9GB RAM, chạy được bằng CPU | Local |
| 14. Đọc lời thuyết minh tiếng Việt | VieNeu-TTS | VieNeu-TTS v3 Turbo (Apache-2.0, thương mại được) | Chạy được bằng CPU; GPU khoảng 1GB VRAM | Local |
| 15. Clip ngắn 5 giây từ chữ hoặc ảnh | InvokeAI, Draw Things (Wan 2.2); mã trong repo Wan | Wan 2.1 1.3B, Wan 2.2 TI2V-5B (Apache-2.0, thương mại được) | InvokeAI: Wan 2.2 TI2V-5B từ 8GB VRAM, RAM 16GB; repo Wan 2.1 1.3B: khoảng 8,2GB VRAM (480P) | Kết hợp: bản gốc model lớn cần GPU 45–80GB |
ComfyUI (GPL-3.0) là engine dạng node cho người muốn tuỳ biến sâu. Chi tiết: Tạo ảnh bằng AI Local và AI Local cho video và giọng nói.
Nguồn: InvokeAI · Z-Image-Turbo · FLUX.2 klein 4B · SDXL · Qwen-Image-Edit · Qwen-Image-2.1 · BFL · Draw Things · Forge Neo · whisper.cpp · PhoWhisper · VieNeu-TTS · viXTTS · Wan 2.1 · Wan 2.2 · Luật Trí tuệ nhân tạo – Điều 11 · Meta · TikTok · YouTube
Nhóm 3. Sale và chăm sóc khách hàng (7 việc)
| Việc | Công cụ | Model gợi ý | Máy tối thiểu* | Nên |
|---|---|---|---|---|
| 16. Soạn bộ câu hỏi thường gặp từ tài liệu sản phẩm | LM Studio (chat với tài liệu), AnythingLLM | Chữ vừa | Mức 2 | Local |
| 17. Trợ lý tra giá, chính sách cho nhân viên sale | Open WebUI (Knowledge gắn vào model) | Chữ vừa và model nhúng | Mức 2, tăng context từ 8.192 | Local |
| 18. Gợi ý trả lời tin nhắn, nhân viên duyệt rồi gửi | n8n (AI Agent, Ollama Chat Model, người duyệt) | Chữ lớn, hãng ghi mạnh về gọi công cụ (vd qwen3.6) | Mức 3 | Kết hợp |
| 19. Chatbot website chỉ trả lời từ tài liệu | AnythingLLM bản Docker (widget, chế độ Query) | Chữ vừa | Mức 2 | Local; tiền, khiếu nại chuyển người |
| 20. Phân loại khách nóng, ấm, lạnh từ form | n8n và Ollama | Chữ vừa | Mức 2 | Local: dữ liệu khách ở lại máy |
| 21. Tóm tắt cuộc gọi tư vấn từ file ghi âm | whisper.cpp và Ollama | Whisper, chữ vừa | Mức 2 | Local; báo khách trước khi ghi âm |
| 22. Trả lời khách 24/7 trên kênh có người lạ nhắn | OpenClaw, Hermes | Chữ lớn nhất máy chạy được | Mức 3 trở lên, context từ 64.000 token | Kết hợp hoặc cloud |
Việc 16, 17, 20, 21 là việc nội bộ, dữ liệu khách không rời máy. Việc 18 và 22 chạm tới khách: tài liệu OpenClaw khuyên không dùng model nhỏ hoặc yếu cho Agent có công cụ hay hộp thư không tin cậy, vì model local không có bộ lọc an toàn như dịch vụ đám mây; OpenClaw có chế độ giữ model cloud làm dự phòng. n8n có bước người duyệt (Approve/Deny) trước khi gửi.
Nguồn: LM Studio RAG · Open WebUI Knowledge · n8n Human-in-the-loop · AnythingLLM chat widgets · OpenClaw local models · Hermes providers · Điều khoản Zalo
Nhóm 4. Vận hành, tài liệu và Excel (7 việc)
| Việc | Công cụ | Model gợi ý | Máy tối thiểu* | Nên |
|---|---|---|---|---|
| 23. Hỏi đáp quy trình, tài liệu nội bộ | AnythingLLM Desktop, Open WebUI Knowledge | Chữ vừa và model nhúng | Mức 2 (AnythingLLM khuyên RAM 16GB) | Local |
| 24. Tóm tắt PDF, Word dài | LM Studio, AnythingLLM | Chữ vừa | Mức 2, tăng context | Local |
| 25. Đọc PDF scan, ảnh chứng từ thành chữ | Open WebUI với Docling (có OCR) | Chữ vừa | Mức 2 | Local |
| 26. Phân tích file bán hàng CSV, vẽ biểu đồ | Open WebUI (Code Interpreter, pandas) | Chữ lớn (viết code) | Mức 3 | Local |
| 27. Làm slide từ dàn ý | Marp (model viết Markdown), Presenton | Chữ vừa | Mức 2 | Local |
| 28. Tạo nháp file Word, Excel, PowerPoint | AnythingLLM (agent Document Generation) | Từ 8B trở lên | Mức 2 | Local |
| 29. Trích tên, số điện thoại, sản phẩm từ email, đơn hàng vào bảng | n8n và Ollama | Chữ vừa | Mức 2 | Local |
Đây là nhóm có lợi thế rõ nhất của AI Local: hợp đồng, bảng lương, đơn hàng không phải gửi lên máy chủ bên ngoài. LM Studio xử lý tài liệu hoàn toàn offline. Vài giới hạn có nguồn: file PPTX của Marp mặc định là ảnh nền nên không sửa được chữ; AnythingLLM khuyên model từ 8B khi tạo PowerPoint; Python chạy trong trình duyệt (Pyodide) của Open WebUI có sẵn pandas nhưng AI không cài thêm thư viện được, nên lưu Excel thành CSV trước. Chi tiết: AI Local làm slide, tài liệu, Excel.
Nguồn: AnythingLLM requirements · Document Generation · Open WebUI Docling · Open WebUI Python · Marp CLI · Presenton · LM Studio offline
Nhóm 5. Quản lý và nội bộ (6 việc)
| Việc | Công cụ | Model gợi ý | Máy tối thiểu* | Nên |
|---|---|---|---|---|
| 30. Biên bản họp từ ghi âm | whisper.cpp và Open WebUI | Whisper, chữ vừa | Mức 2 | Local |
| 31. Báo cáo tuần: tóm tắt số liệu, viết nhận xét | n8n (chạy theo lịch) và Ollama | Chữ vừa hoặc lớn | Mức 2 | Local; người đọc kiểm tra số |
| 32. Soạn quy trình (SOP), tài liệu đào tạo nhân viên mới | Open WebUI | Chữ lớn | Mức 3 | Kết hợp |
| 33. Trợ lý chat chung, mỗi người một tài khoản | Open WebUI trên một máy chung | Chữ vừa hoặc lớn | Mức 3 cho máy chung | Local, thêm kết nối cloud cho việc khó |
| 34. Văn bản nhân sự, hợp đồng có dữ liệu nhạy cảm | LM Studio (chạy offline) | Chữ vừa | Mức 2 | Local |
| 35. Dịch tài liệu nội bộ Anh – Việt | Ollama, LM Studio | Chữ vừa hoặc lớn | Mức 2 | Local; bản gửi đối tác cần người duyệt |
Việc 33 là bước chuyển từ "một người dùng" sang "cả nhóm dùng": một máy chung chạy Ollama, Open WebUI làm giao diện, mỗi người một tài khoản, kho kiến thức và mẫu câu lệnh dùng chung. Lộ trình, người phụ trách và cách kiểm thử ở Lộ trình xây hệ thống AI Local; chi phí và bảo mật ở Chi phí thật và bảo mật.
Nguồn: whisper.cpp · Open WebUI Knowledge · LM Studio offline
Nhóm 6. Lập trình và kỹ thuật (5 việc)
| Việc | Công cụ | Model gợi ý | Máy tối thiểu* | Nên |
|---|---|---|---|---|
| 36. Gợi ý, giải thích code trong trình soạn thảo | Continue, Cline với Ollama | devstral:24b (14GB) hoặc qwen3-coder:30b (19GB), Apache-2.0 | Mức 3 | Local |
| 37. Viết script nhỏ: gộp file, đổi tên hàng loạt | Aider, Codex CLI (cờ --oss) | Code | Mức 3 | Kết hợp; đọc lệnh trước khi cho chạy |
| 38. Agent lập trình nhiều bước trên dự án lớn | Cline; Claude Code trỏ vào Ollama | qwen3-coder-next (52GB, Apache-2.0) | Mức 4 | Kết hợp: dự án quan trọng dùng cloud |
| 39. Bộ não cho OpenClaw, Hermes, n8n | Ollama, llama.cpp, LM Studio | Chữ lớn, hỗ trợ gọi công cụ | Mức 3, context từ 64.000 token | Kết hợp |
| 40. Router: local làm chính, cloud dự phòng, theo dõi chi phí | LiteLLM; OpenClaw chế độ merge | Local và cloud | Máy chung hoặc máy chủ | Kết hợp |
Mistral ghi Devstral bản đầu chạy được trên một card RTX 4090 hoặc Mac 32GB RAM; Cline gợi ý từ 64GB cho model lớn và context dài. Claude Code dùng được model local qua API tương thích Anthropic của Ollama. Khi cho AI chạy lệnh trên máy, luôn đọc lệnh trước khi bấm đồng ý. Chi tiết: AI Local cho lập trình và Dùng AI Local làm bộ não cho Agent.
Nguồn: Continue + Ollama · Cline local models · Aider + Ollama · Codex CLI config · Devstral · Qwen3-Coder-Next · Ollama Anthropic API · LiteLLM fallbacks · OpenClaw local models
Chọn 3 việc đầu tiên thế nào?
- Lọc theo máy đang có: giữ lại các việc có mức máy bằng hoặc thấp hơn máy của bạn. Chưa chắc máy mình thuộc mức nào, xem Cấu hình máy chạy AI Local.
- Ưu tiên việc lặp lại và dữ liệu nhạy cảm: mô tả sản phẩm hàng loạt, chép lời, hỏi đáp tài liệu nội bộ, phân loại khách. Đây là chỗ không tính phí theo lượt và dữ liệu ở lại máy phát huy rõ.
- Thử 2–3 model trên việc thật: chọn model trong bản đồ model mở, cài theo hướng dẫn cài Ollama, LM Studio, chấm điểm bằng bộ câu hỏi thật trước khi cho cả nhóm dùng.
Muốn được tư vấn hoặc cài đặt AI Local theo nhu cầu riêng, bạn có thể đăng ký Tư vấn 1-1 hoặc Coaching 1-1 cho doanh nghiệp; chi phí báo sau buổi tư vấn.
Đọc tiếp: Lộ trình xây hệ thống →
Câu hỏi thường gặp
Một máy có làm được cả 40 việc trong bài không?
Không nên kỳ vọng như vậy. Máy 16GB làm tốt nhóm việc chữ như viết nháp, tóm tắt, phân loại, chép lời. Chatbot có gọi công cụ, trợ lý code và tạo ảnh chất lượng cao cần máy mạnh hơn. Model video lớn chạy bản gốc theo repo chính thức cần GPU 45–80GB (Wan 2.2 A14B, HunyuanVideo), thực tế là thuê GPU; InvokeAI ghi mức tối thiểu thấp hơn với bản nén. Hãy chọn 3 việc hợp với máy đang có trước.
Máy 8GB RAM dùng AI Local được việc gì?
Chép lời và làm phụ đề bằng whisper.cpp (bản large cần khoảng 3,9GB RAM, chạy được bằng CPU), cùng các việc chữ ngắn với model nhỏ như qwen3.5:4b hoặc gemma4:e2b bản qat (Apache-2.0). LM Studio ghi máy 8GB chỉ chạy được model nhỏ, nên đừng giao việc dài hay việc cần suy luận nhiều.
Ảnh và giọng đọc tạo bằng AI Local có dùng để bán hàng được không?
Tuỳ giấy phép của từng model. Z-Image-Turbo, FLUX.2 [klein] 4B, dòng Qwen-Image (trừ Qwen-Image-2.1), Wan 2.1 và 2.2, VieNeu-TTS v3 Turbo cho dùng thương mại. FLUX.1 [dev], FLUX.2 [dev], viXTTS, F5-TTS tiếng Việt chỉ dùng phi thương mại. Khi đăng quảng cáo, gắn nhãn nội dung AI theo quy định của nền tảng và Luật Trí tuệ nhân tạo.
Model local nào viết tiếng Việt tốt?
Chưa có bảng xếp hạng tiếng Việt chính thức cho các model mở. Model card chỉ ghi danh sách hoặc số ngôn ngữ (Qwen3.5 ghi 201 ngôn ngữ và phương ngữ; Phi-4-mini không có tiếng Việt). Cách đáng tin là chạy 2–3 model vừa máy trên chính bộ câu hỏi thật của doanh nghiệp rồi chấm điểm.
Khi nào nên chuyển việc sang Claude hoặc ChatGPT?
Khi việc khó và cần chất lượng cao nhất, cần tìm thông tin mới trên web, cần context dài mà máy không đủ bộ nhớ, hoặc khi bot tiếp khách lạ có quyền dùng công cụ. Cách thực tế là kết hợp: việc thường ngày và dữ liệu nhạy cảm chạy local, phần còn lại dùng đám mây.
Tài liệu liên quan
- AI AgentChọn công cụ AI Agent: OpenClaw, Hermes, Claude, ChatGPT hay n8n?Chọn công cụ AI Agent: so sánh trung lập Claude, ChatGPT, OpenClaw, Hermes và n8n theo 10 tiêu chí có nguồn, kèm cách chọn cho 7 tình huống doanh nghiệp Việt.
- AI AgentKết hợp Claude, ChatGPT, OpenClaw, Hermes và n8n trong một doanh nghiệpKết hợp công cụ AI Agent trong doanh nghiệp: phân vai trợ lý, hệ thống 24/7 và n8n, luồng dữ liệu, quyền, chi phí, người phụ trách, lộ trình 30–60–90 ngày.
- AI AgentChatbot bán hàng chạy AI Local: trả lời tin nhắn, kho kiến thức sản phẩmChatbot bán hàng chạy AI Local: nối kênh chat qua n8n, OpenClaw, Hermes với model trên máy, kho kiến thức; ranh giới, người duyệt, kiểm thử, lúc cần đám mây.
- AI AgentDùng AI Local làm bộ não cho OpenClaw, Hermes, n8nDùng AI Local làm bộ não cho AI Agent: endpoint tương thích OpenAI, cấu hình OpenClaw, Hermes, n8n theo docs, chạy lai local và cloud, nối VPS qua Tailscale.
Xem tất cả tài liệu hướng dẫn →
Đăng ký Tư vấn 1-1 về AI Local
Chuyên gia Aduca cùng bạn xem nhu cầu, máy đang có và dữ liệu cần bảo vệ, rồi đề xuất nên chạy AI Local, dùng đám mây hay kết hợp. Dịch vụ cài AI Local nằm trong gói Tư vấn 1-1 hoặc Coaching 1-1; chi phí báo sau buổi tư vấn.
Nguồn tham khảo
- Ollama Docs – Context length (context mặc định theo VRAM)
- Ollama – Thư viện model qwen3.5 (dung lượng file)
- Open WebUI Docs – Knowledge
- InvokeAI – Yêu cầu hệ thống theo từng model ảnh, video
- Black Forest Labs – Giấy phép FLUX
- whisper.cpp (GitHub) – bộ nhớ theo cỡ model
- VieNeu-TTS (GitHub) – đọc tiếng Việt, Apache-2.0
- Wan 2.1 (GitHub) – model video mở, yêu cầu VRAM
- AnythingLLM Docs – Document Generation agent
- OpenClaw Docs – Local models
Lịch sử cập nhật
- 07/10/2026 — Bản đầu.
Miễn trừ trách nhiệm
Bài viết thuộc chuỗi kiến thức của Công ty Cổ phần Giáo dục Aduca, chia sẻ miễn phí cho mục đích học tập. Thông tin kỹ thuật đối chiếu với tài liệu chính thức của các dự án và nền tảng tại ngày cập nhật (có ghi nguồn); phần nhận định là quan điểm của Aduca. OpenClaw, Hermes Agent, Claude (thương hiệu của Anthropic), ChatGPT (thương hiệu của OpenAI), n8n (thương hiệu của n8n GmbH), các phần mềm chạy model và các model AI mở (Ollama, LM Studio, Qwen, Gemma, gpt-oss…) cùng các phần mềm, dịch vụ nêu trong bài thuộc về chủ sở hữu tương ứng, không thuộc Aduca; Aduca không phải đối tác chính thức của các công ty này. Tính năng, gói và giá có thể thay đổi bất cứ lúc nào – hãy kiểm tra trang chính thức trước khi mua. Kết quả áp dụng phụ thuộc quy trình, dữ liệu và con người của từng doanh nghiệp; bài viết không cam kết doanh thu hay hiệu quả cụ thể. © 2026 Aduca — được trích dẫn khi ghi rõ nguồn aduca.vn.