Chi phí thật và bảo mật khi dùng AI Local
AI Local không tốn phí API theo lượt, nhưng không miễn phí: có tiền máy, tiền điện, công vận hành. Và máy chạy model là một máy chủ cần được bảo vệ. Bài viết đưa công thức để bạn tự điền số của mình, các lỗ hổng đã công bố cùng bản vá, cách truy cập từ xa an toàn và một checklist bảo mật. Dữ kiện kiểm tra ngày 07/10/2026.
Phần mềm miễn phí, nhưng AI Local không miễn phí
Chị Thu bán mỹ phẩm online, nghe nói AI Local "không tốn phí API" nên mua card đồ hoạ mới, cho máy chạy model cả ngày. Rồi nhân viên muốn dùng từ nhà, một người quen mở máy ra Internet cho tiện. Chị chưa tính tiền điện, cũng không biết giờ người lạ trên Internet cũng gọi được vào máy. (Tình huống minh hoạ.)
Hai rủi ro ở đây: chi phí không được tính trước, và máy chạy model bị lộ ra ngoài. Bài này giúp bạn tự tính chi phí bằng số của mình, rồi khoá an toàn chiếc máy đó. Chưa rõ AI Local là gì, đọc trước AI Local là gì.
Năm khoản chi của AI Local
| Khoản | Cách tính | Ghi chú |
|---|---|---|
| Phần mềm | Thường 0 đồng | Ollama, llama.cpp, Jan, LM Studio miễn phí; Open WebUI có điều khoản thương hiệu khi trên 50 người dùng |
| Máy | Giá máy ÷ số tháng dự kiến dùng | Mua mới hoặc nâng cấp; lấy báo giá thật tại nơi bạn mua |
| Điện | Công suất (W) × số giờ chạy ÷ 1000 × giá điện | Giá điện theo hoá đơn hoặc biểu giá hiện hành của EVN |
| Công vận hành | Số giờ công × đơn giá giờ công nội bộ | Cài đặt, cập nhật bản vá, theo dõi, sao lưu |
| Thuê GPU (nếu không mua) | Giá thuê mỗi giờ × số giờ | Chạy 24/7 cả tháng là khoảng 730 giờ (8.760 giờ/năm ÷ 12) |
Giá thuê GPU tham khảo trên RunPod (một ví dụ, không phải khuyến nghị), USD mỗi giờ, 10/2026:
| Card | Gói Community | Gói Secure |
|---|---|---|
| RTX 4090 | 0,34 | 0,74 |
| RTX 5090 | 0,69 | 0,99 |
| L40S | 0,79 | 1,09 |
| A100 80GB PCIe | 1,19 | 1,59 |
| H100 SXM | 2,69 | 3,49 |
Nguồn: RunPod pricing · Ollama · LM Studio free for work · Open WebUI license · EVN
Công thức tự tính chi phí AI Local
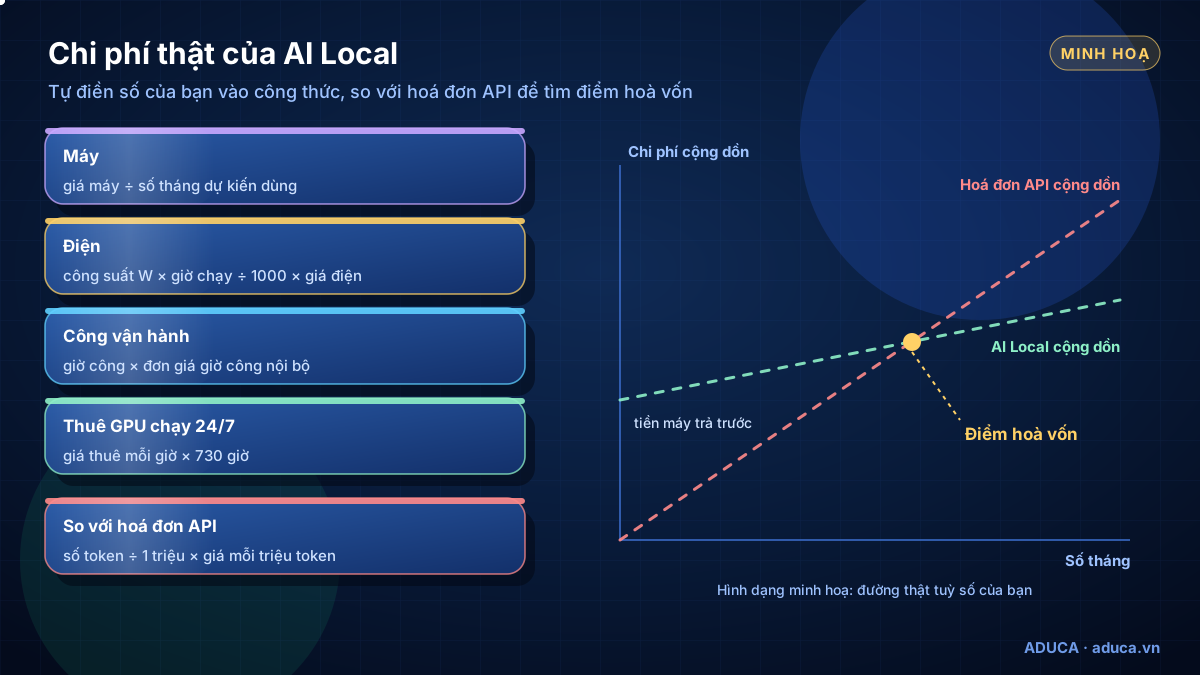
Aduca không ghi sẵn giá máy hay giá điện tại Việt Nam vì chúng khác nhau theo nơi mua, theo bậc điện và theo thời điểm. Bạn copy bảng dưới, điền số của chính mình vào phần trong <…>:
# 1. Tiền máy mỗi tháng
Tiền máy/tháng = <giá máy> ÷ <số tháng dự kiến dùng>

# 2. Tiền điện mỗi tháng
Số kWh/tháng   = <công suất W> × <giờ chạy mỗi ngày> × <số ngày> ÷ 1000
Tiền điện      = Số kWh/tháng × <giá điện đồng/kWh>

# 3. Công vận hành mỗi tháng
Tiền công      = <số giờ công> × <đơn giá giờ công nội bộ>

# Tổng AI Local mỗi tháng
Local/tháng    = Tiền máy/tháng + Tiền điện + Tiền công

# 4. Nếu thuê GPU thay vì mua máy (chạy 24/7)
Thuê/tháng     = <giá thuê mỗi giờ> × 730

# 5. Hoá đơn API mỗi tháng (để so sánh)
API/tháng      = <token vào> ÷ 1.000.000 × <giá vào> + <token ra> ÷ 1.000.000 × <giá ra>
Ví dụ minh hoạ (ước tính)
- Điện, riêng card đồ hoạ: RTX 5090 có tổng công suất đồ hoạ (TGP) 575W. Nếu chạy đầy tải 8 giờ mỗi ngày trong 30 ngày: 575 × 240 ÷ 1000 = 138 kWh/tháng, chưa tính CPU, màn hình, làm mát. Công suất thực khi chạy model tuỳ máy và tải; muốn chính xác, đo bằng ổ cắm có đồng hồ điện, rồi nhân với giá điện của bạn.
- Thuê GPU chạy 24/7: RTX 4090 gói Community 0,34 × 730 ≈ 248 USD/tháng; gói Secure 0,74 × 730 ≈ 540 USD/tháng (theo giá RunPod tháng 10/2026).
- Hoá đơn API: giả sử mỗi tháng 20 triệu token đầu vào và 5 triệu token đầu ra với Claude Haiku 4.5 (1 USD / 5 USD mỗi triệu token): 20 × 1 + 5 × 5 = 45 USD/tháng. Với Sonnet 5.5 (2 USD / 10 USD) là 90 USD/tháng. Giá tại 10/2026, có thể thay đổi.
Lưu ý khi ước tính: Batch API của Claude giảm 50% cho việc không gấp; model từ Claude 4.7 trở đi (như Sonnet 5.5, không gồm Haiku 4.5) dùng bộ tách token mới, tạo khoảng 30% nhiều token hơn cho cùng văn bản, nên cộng dư.
Nguồn: NVIDIA RTX 5090 · RunPod pricing · Claude pricing
So với hoá đơn API: tìm điểm hoà vốn
Điểm hoà vốn là tháng mà tổng chi phí AI Local cộng dồn bằng hoặc thấp hơn tổng hoá đơn API cộng dồn. Khi mua máy, AI Local tốn nhiều ở tháng đầu rồi tăng chậm; API bắt đầu từ 0 nhưng tăng theo lượng dùng.
- Lấy số token mỗi tháng từ trang mức dùng của nhà cung cấp API, tính API/tháng.
- Tính Local/tháng theo bảng trên.
- Cộng dồn từng tháng cho cả hai bên, tìm tháng hai đường gặp nhau.
Bảo mật 1: chỉ nghe trên máy, không mở cổng ra Internet
Ollama mặc định chỉ nghe ở 127.0.0.1:11434, tức chỉ chính máy đó gọi được. Đổi biến OLLAMA_HOST sẽ đổi địa chỉ nghe, và có thể mở cho máy khác vào. llama-server mặc định nghe 127.0.0.1:8080.
Vấn đề nằm ở chỗ API của Ollama không có xác thực: khoá API trong lời gọi kiểu OpenAI bị bỏ qua, và bản ghi CVE nêu các endpoint /api/create, /api/push không có xác thực trong bản phát hành gốc. LM Studio mặc định cũng không yêu cầu xác thực; bạn phải tự bật API token. Nghĩa là ai gọi tới được cổng là dùng được model của bạn.
Đây không phải rủi ro lý thuyết: trong bài blog ngày 01/09/2025, Cisco dùng công cụ Shodan và tìm thấy 1.139 máy chủ Ollama lộ ra Internet, kèm khuyến nghị bắt buộc xác thực, phân vùng mạng, tường lửa, giới hạn tần suất và giám sát.
Nguồn: Ollama FAQ · llama-server · Ollama API · CVE-2026-7482 · LM Studio auth · Cisco Blog
Bảo mật 2: lỗ hổng đã công bố và bản vá
Phần mềm chạy model cũng là phần mềm máy chủ, và đã có nhiều lỗ hổng được công bố kèm bản vá:
| Phần mềm | Lỗ hổng đã công bố | Cách xử lý |
|---|---|---|
| Ollama | CVE-2026-7482 (CVSS 3.1: 9.1, nghiêm trọng): đọc tràn bộ nhớ khi xử lý file GGUF qua /api/create ở các bản trước 0.17.1; có thể lộ biến môi trường, khoá API, prompt hệ thống, hội thoại của người khác | Cập nhật lên 0.17.1 trở lên |
| llama.cpp | CVE-2026-34159 (9.8): chạy mã từ xa không cần xác thực qua RPC backend, các bản trước b8492 theo bản ghi CVE; CVE-2026-33298 (7.8, vá ở b7824); CVE-2026-27940 (7.8, vá từ b8146) | Cập nhật bản mới; không mở RPC backend ra mạng; chỉ tải GGUF từ nguồn tin cậy |
| vLLM | Bản 0.31.0 vá loạt cảnh báo, trong đó có lỗi cho phép chạy mã từ xa (8.1) ảnh hưởng từ 0.7.3 đến trước 0.31.0 | Cập nhật lên 0.31.0 trở lên |
| Open WebUI | Bản 0.11.4 vá nhiều cảnh báo, ví dụ lỗi cho trang web bất kỳ lấy cắp token phiên đăng nhập (8.1), ảnh hưởng từ 0.7.0 đến trước 0.11.4 | Cập nhật lên 0.11.4 trở lên |
| AnythingLLM | CVE-2026-48116 (7.5): chạy mã từ xa qua kỹ năng tìm tệp của agent, ảnh hưởng các bản đến 1.12.1; thêm các cảnh báo 09/2026 đến bản 1.16.1 | Cập nhật lên 1.17.0 |
Thói quen nên có: theo dõi trang phát hành và trang cảnh báo bảo mật của từng phần mềm, kiểm tra bản mới mỗi tháng. Ollama trên Linux cập nhật bằng cách chạy lại script cài đặt:
ollama -v                                      # xem phiên bản đang chạy
curl -fsSL https://ollama.com/install.sh | sh   # Linux: chạy lại script cài để cập nhật
Nguồn: CVE-2026-7482 · Ollama v0.17.1 · llama.cpp advisories · vLLM advisories · Open WebUI advisories · AnythingLLM advisories · Ollama Linux
Bảo mật 3: dùng từ xa qua VPN hoặc reverse proxy có xác thực
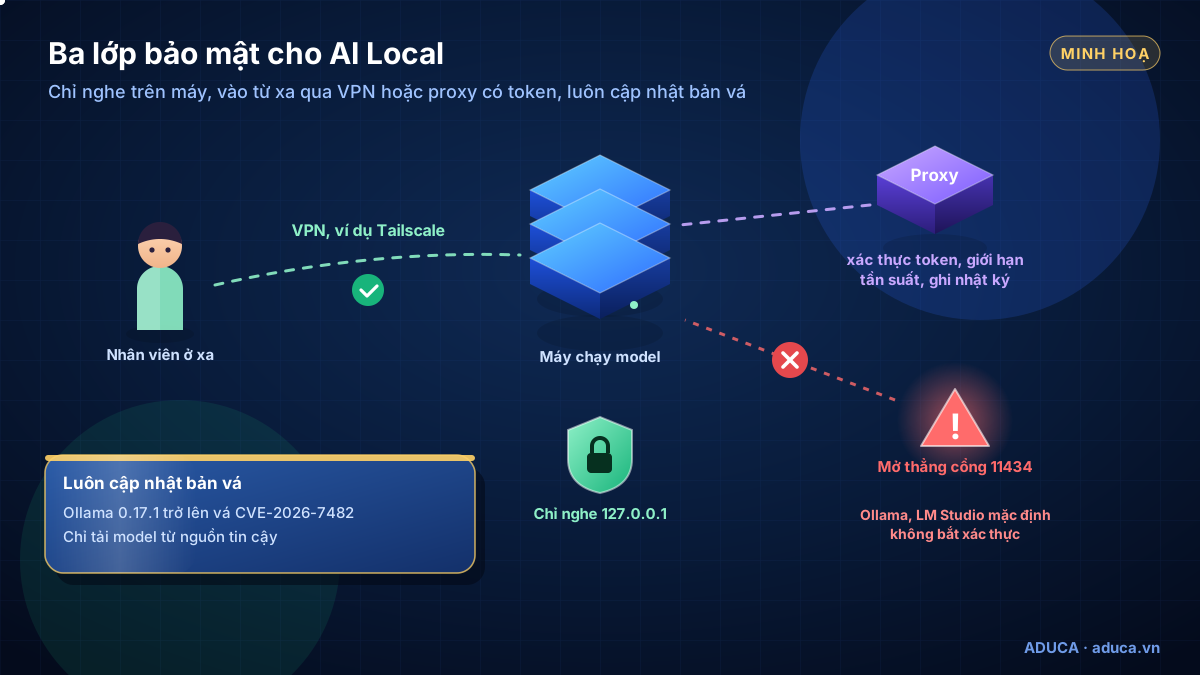
- VPN: ví dụ Tailscale, mạng riêng mã hoá dựa trên WireGuard; chỉ thiết bị trong mạng của bạn mới thấy máy chạy model. Gói Personal miễn phí, tối đa 6 người dùng (10/2026, có thể thay đổi).
- Reverse proxy có xác thực: đặt nginx hoặc Envoy phía trước, bắt buộc token, chỉ mở các đường dẫn cần thiết, giới hạn tần suất, ghi nhật ký. Tài liệu vLLM khuyến nghị cách này; áp dụng tương tự cho Ollama vì Ollama không có xác thực.
- Bật xác thực sẵn có: llama-server có
--api-keyhoặc--api-key-file; LM Studio có API token (Developers, Server Settings), ứng dụng gửi kèmAuthorization: Bearer.--api-keycủa vLLM không bảo vệ mọi endpoint (ví dụ/invocations), nên vẫn cần proxy.
Nối máy chạy model ở văn phòng với VPS chạy OpenClaw, Hermes hay n8n: Dùng AI Local làm bộ não cho OpenClaw, Hermes, n8n.
Nguồn: What is Tailscale · Tailscale pricing · vLLM security · llama-server · LM Studio auth
Bảo mật 4: dữ liệu, quyền truy cập và sao lưu
- Biết lúc nào dữ liệu rời máy: model đuôi
-cloudcủa Ollama, tính năng tìm web, hoặc app nối với API đám mây. Muốn chắc chắn, đặtOLLAMA_NO_CLOUD=1. - Phân quyền: trong Open WebUI, tài khoản đầu tiên là quản trị, đăng ký mới mặc định tắt. Giữ như vậy, tạo tài khoản cho từng người, đặt
WEBUI_SECRET_KEYriêng (tạo bằngopenssl rand -hex 32). - Sao lưu: lịch sử chat của Open WebUI nằm trong volume Docker
open-webui(theo lệnh cài chính thức); sao lưu volume này cùng prompt hệ thống và cấu hình. File model tải lại được. - Dữ liệu khách: chỉ đưa vào AI phần thật sự cần, ẩn danh khi có thể, theo Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15.
- Agent tiếp khách: model local không có bộ lọc an toàn của nhà cung cấp, và tài liệu OpenClaw khuyên không dùng model nhỏ, yếu cho hộp thư người lạ. Agent không được quyền chạy lệnh; câu về tiền, khiếu nại chuyển cho người.
Nguồn: Ollama FAQ · Ollama Cloud · Open WebUI · OpenClaw local models · OpenClaw prompt injection
Checklist bảo mật AI Local
- Phần mềm chạy model chỉ nghe 127.0.0.1 (kiểm tra
OLLAMA_HOST, cờ--host). - Không mở cổng 11434, 1234, 8080, 8000 ra Internet trên router hay tường lửa.
- Truy cập từ xa chỉ qua VPN hoặc reverse proxy có token; bật API token của LM Studio, llama-server.
- Ollama từ 0.17.1, Open WebUI từ 0.11.4, vLLM từ 0.31.0, AnythingLLM từ 1.17.0; kiểm tra bản mới mỗi tháng.
- Chỉ tải model từ nguồn tin cậy; không mở RPC backend của llama.cpp ra mạng.
- Khoá, token nằm trong biến môi trường hoặc tệp .env, không gửi qua chat.
- Biết model nào là
-cloud; đặtOLLAMA_NO_CLOUD=1nếu dữ liệu không được rời máy. - Open WebUI: tắt đăng ký tự do, mỗi người một tài khoản, có
WEBUI_SECRET_KEYriêng. - Sao lưu volume dữ liệu và cấu hình; thử khôi phục ít nhất một lần.
- Agent tiếp khách không có quyền chạy lệnh; việc tiền, khiếu nại chuyển người.
- Ghi rõ ai phụ trách cập nhật, theo dõi và sao lưu.
Làm gì tiếp theo?
Chọn máy: Cấu hình máy tính chạy AI Local. Đi từ một máy lên cả đội: Lộ trình xây hệ thống AI Local.
Muốn được tư vấn hoặc cài đặt AI Local theo nhu cầu riêng, bạn có thể đăng ký Tư vấn 1-1 hoặc Coaching 1-1 cho doanh nghiệp; chi phí báo sau buổi tư vấn.
Đọc tiếp: 40 việc AI Local làm được →
Câu hỏi thường gặp
Chạy AI Local tốn bao nhiêu tiền điện?
Tính theo công thức: công suất (W) × số giờ chạy ÷ 1000 × giá điện mỗi kWh. Ví dụ minh hoạ: riêng card RTX 5090 có công suất đồ hoạ 575W, chạy đầy tải 8 giờ mỗi ngày trong 30 ngày là 138 kWh, chưa tính CPU, màn hình, làm mát. Bạn nhân số kWh với giá điện trên hoá đơn của mình.
Nên thuê GPU theo giờ hay mua máy?
Thuê chạy suốt tháng tốn khoảng giá mỗi giờ × 730. Ví dụ minh hoạ theo bảng giá RunPod tháng 10/2026: RTX 4090 gói Community 0,34 USD/giờ, tức khoảng 248 USD/tháng nếu chạy 24/7. Thuê hợp khi cần thử nghiệm hoặc dùng không đều; mua hợp khi dùng đều và lâu dài. Hãy tính cả hai bằng số của bạn.
Khi nào AI Local rẻ hơn dùng API?
Khi tổng chi phí AI Local cộng dồn (máy chia theo tháng, điện, công vận hành) thấp hơn tổng hoá đơn API cộng dồn cho cùng khối lượng việc và cùng chất lượng đầu ra. Lượng dùng càng lớn và đều thì điểm hoà vốn càng sớm; dùng ít thì API có thể rẻ hơn.
Ollama có an toàn không?
Mặc định Ollama chỉ nghe trên chính máy đó (127.0.0.1:11434), nhưng API của nó không có xác thực. Vì vậy đừng mở cổng ra Internet, và cập nhật thường xuyên: lỗ hổng nghiêm trọng CVE-2026-7482 đã được vá từ bản 0.17.1.
Muốn dùng AI Local ở nhà thì có nên mở cổng ra Internet không?
Không nên. Hãy dùng VPN (ví dụ Tailscale) để chỉ thiết bị của bạn vào được mạng riêng, hoặc đặt reverse proxy có token, giới hạn tần suất và ghi nhật ký phía trước. Cisco từng tìm thấy hơn một nghìn máy chủ Ollama lộ ra Internet.
Tài liệu liên quan
- AI Local · AI AgentAI Local là gì? Chạy AI ngay trên máy tính, không tốn phí APIAI Local là gì: chạy model AI mở ngay trên máy tính của bạn, không trả phí API theo lượt, dữ liệu ở lại máy. Lợi ích, giới hạn, so sánh với AI đám mây.
- AI Local · AI AgentCấu hình máy tính chạy AI Local: RAM, VRAM, Mac hay PC NVIDIACấu hình máy tính chạy AI Local: RAM, VRAM quyết định model nào chạy được, cách ước tính dung lượng theo Q4/Q8, Mac hay PC NVIDIA, ổ cứng, mua máy hay thuê GPU.
- AI Local · AI AgentBản đồ model AI mở 2026: chọn model theo việc và theo máyBản đồ model AI mở 2026: Qwen, Gemma 4, gpt-oss, Llama 4, Mistral, GLM, DeepSeek, Phi; cỡ, MoE hay dense, giấy phép thương mại, tag Ollama, tự thử tiếng Việt.
- AI Local · AI AgentCài AI Local trong 30 phút: Ollama, LM Studio và Open WebUICài AI Local từng bước trên Windows, macOS, Linux: chọn Ollama, LM Studio, Jan hay llama.cpp, chạy thử model nhỏ, đặt context, dựng Open WebUI cho nhóm.
Xem tất cả tài liệu hướng dẫn →
Đăng ký Tư vấn 1-1 về AI Local
Chuyên gia Aduca cùng bạn xem nhu cầu, máy đang có và dữ liệu cần bảo vệ, rồi đề xuất nên chạy AI Local, dùng đám mây hay kết hợp. Dịch vụ cài AI Local nằm trong gói Tư vấn 1-1 hoặc Coaching 1-1; chi phí báo sau buổi tư vấn.
Nguồn tham khảo
- RunPod – bảng giá thuê GPU theo giờ
- Claude Docs – bảng giá API
- NVIDIA – thông số RTX 5090
- Ollama Docs – FAQ (cổng mặc định, OLLAMA_HOST)
- CVE.org – CVE-2026-7482 (Ollama)
- llama.cpp – cảnh báo bảo mật
- Cisco Blog – máy chủ Ollama lộ ra Internet
- LM Studio Docs – xác thực API
- vLLM Docs – bảo mật
- Tailscale – What is Tailscale
Lịch sử cập nhật
- 07/10/2026 — Bản đầu.
Miễn trừ trách nhiệm
Bài viết thuộc chuỗi kiến thức của Công ty Cổ phần Giáo dục Aduca, chia sẻ miễn phí cho mục đích học tập. Thông tin kỹ thuật đối chiếu với tài liệu chính thức của các dự án và nền tảng tại ngày cập nhật (có ghi nguồn); phần nhận định là quan điểm của Aduca. OpenClaw, Hermes Agent, Claude (thương hiệu của Anthropic), ChatGPT (thương hiệu của OpenAI), n8n (thương hiệu của n8n GmbH), các phần mềm chạy model và các model AI mở (Ollama, LM Studio, Qwen, Gemma, gpt-oss…) cùng các phần mềm, dịch vụ nêu trong bài thuộc về chủ sở hữu tương ứng, không thuộc Aduca; Aduca không phải đối tác chính thức của các công ty này. Tính năng, gói và giá có thể thay đổi bất cứ lúc nào – hãy kiểm tra trang chính thức trước khi mua. Kết quả áp dụng phụ thuộc quy trình, dữ liệu và con người của từng doanh nghiệp; bài viết không cam kết doanh thu hay hiệu quả cụ thể. © 2026 Aduca — được trích dẫn khi ghi rõ nguồn aduca.vn.