Làm phụ đề tiếng Việt bằng Whisper chạy trên máy
Hướng dẫn từng bước biến video, bản ghi âm thành tệp phụ đề SRT tiếng Việt bằng Whisper chạy ngay trên máy tính, không gửi tệp lên dịch vụ nào. Ba cách đi: openai-whisper (dễ nhất), whisper.cpp (nhẹ, không cần Python) và faster-whisper (hợp card NVIDIA). Lệnh lấy theo tài liệu chính thức, kiểm tra ngày 20–21/10/2026.
Mỗi video lại mất cả buổi để gõ phụ đề
Đội Marketing quay mỗi tuần vài video, livestream, buổi chia sẻ nội bộ, và video nào cũng cần phụ đề. Gõ tay thì mất cả buổi; dùng dịch vụ trực tuyến thì phải tải tệp lên máy chủ bên ngoài, trong khi bản ghi buổi tư vấn khách hàng không nên rời công ty. (Tình huống minh hoạ.)
Bài này hướng dẫn tạo tệp phụ đề SRT tiếng Việt bằng Whisper chạy ngay trên máy của bạn, đi theo từng bước, kèm cách kiểm tra, xử lý lỗi, cập nhật và gỡ. Muốn xem bức tranh rộng hơn về chép lời, đọc giọng và video ngắn bằng AI Local, đọc trước AI Local cho video và giọng nói.
Làm phụ đề tiếng Việt bằng Whisper chạy trên máy là gì?
Làm phụ đề tiếng Việt bằng Whisper chạy trên máy là dùng model nhận dạng giọng nói mở Whisper, cài trên chính máy tính của bạn, để chép lời video hoặc bản ghi âm thành tệp phụ đề có mốc thời gian (SRT, VTT) mà không gửi tệp ra ngoài.
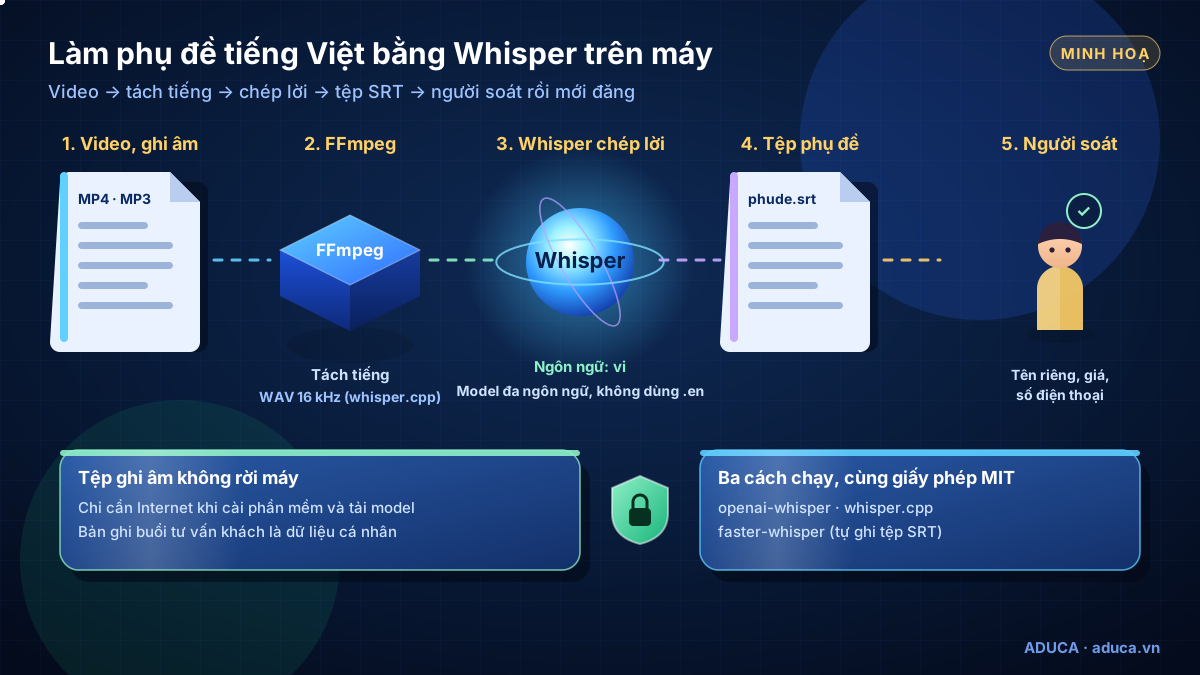
- Tệp gốcVideo MP4 hoặc âm thanh MP3, WAV
- FFmpegĐọc và chuyển định dạng âm thanh
- WhisperChép lời tiếng Việt, gắn mốc thời gian
- Tệp SRTMở được trong CapCut, YouTube, trình phát video
- Người soátSửa tên riêng, số liệu rồi mới đăng
Model Whisper có hỗ trợ tiếng Việt (mã vi). Các bản có đuôi .en chỉ dành cho tiếng Anh, nên với tiếng Việt luôn chọn bản đa ngôn ngữ như turbo hoặc large-v3-turbo.
Nguồn: OpenAI Whisper · Whisper – danh sách ngôn ngữ
Chọn một trong ba cách chạy Whisper
| Cách | Cài thế nào | Điểm mạnh | Cần biết |
|---|---|---|---|
| openai-whisper (bản gốc, MIT; mới nhất v20250625) | Python + pip, cần FFmpeg | Lệnh whisper xuất SRT, VTT, TXT có sẵn; mặc định model turbo | README ghi Python 3.8–3.11; chạy bằng CPU sẽ chậm |
| whisper.cpp (MIT; mới nhất v1.9.5, 06/10/2026) | Tải mã nguồn, build bằng CMake | Không cần Python; Mac chip Apple chạy GPU qua Metal; có CUDA, Vulkan; chạy được bằng CPU thuần | Ngôn ngữ mặc định là tiếng Anh, phải thêm -l vi; nên đổi âm thanh sang WAV 16-bit |
| faster-whisper (MIT; mới nhất v1.2.1) | Python 3.9+ và pip, không cần cài FFmpeg | Nhanh hơn bản gốc trên card NVIDIA theo số đo của dự án; chế độ int8 tiết kiệm bộ nhớ | Không có hàm xuất SRT sẵn, phải viết vài dòng Python; GPU cần CUDA 12 và cuDNN 9 |
Gợi ý: người mới bắt đầu bằng cách 1. Máy Mac chip Apple, hoặc máy không muốn cài Python, dùng cách 2. Có card NVIDIA và cần chép lời nhiều tệp, thử cách 3. Cả ba đều tạo ra cùng một loại tệp SRT.
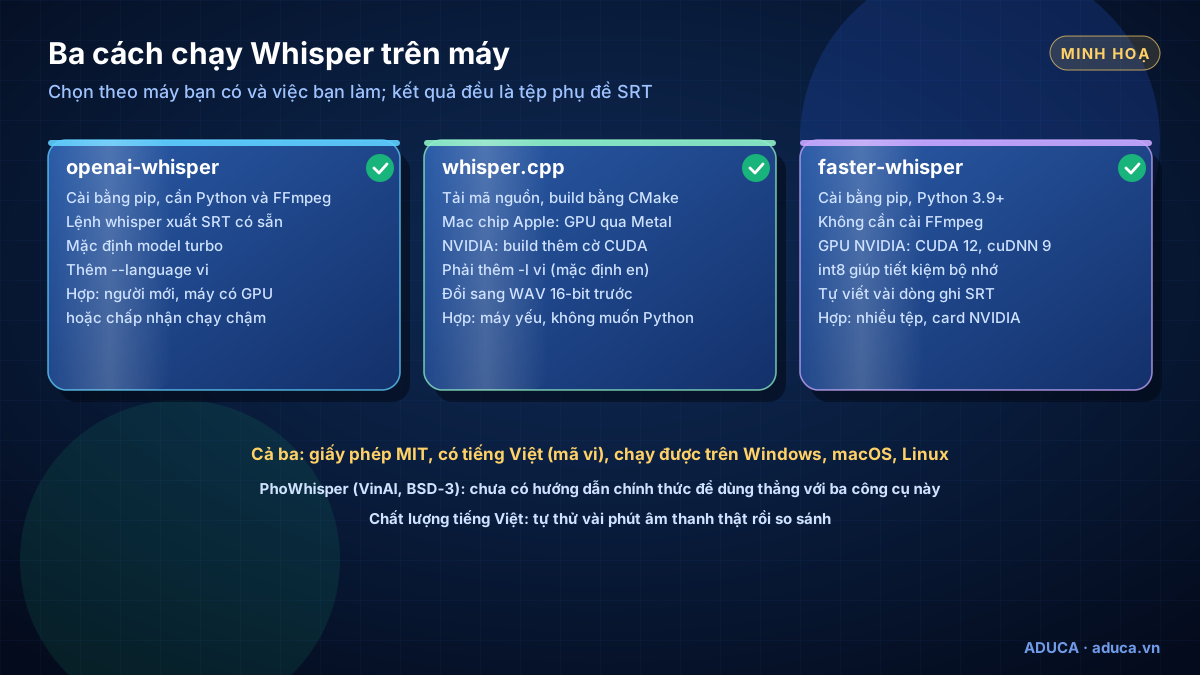
whisper, whisper.cpp hay faster-whisper, và model ở định dạng Transformers nên có thể phải chuyển đổi. Aduca chưa xác minh được cách dùng trực tiếp, nên bài này không đưa lệnh cho PhoWhisper.Nguồn: Whisper v20250625 · whisper.cpp – bản mới nhất · faster-whisper v1.2.1 · faster-whisper – README, số đo · PhoWhisper-large
Chuẩn bị trước khi cài
- FFmpeg cho cách 1 và cách 2 (dùng để đọc, chuyển định dạng âm thanh). Cách 3 không cần.
- Python cho cách 1 (README ghi 3.8–3.11) hoặc cách 3 (3.9 trở lên). Nên tạo môi trường ảo riêng để không đụng các phần mềm Python khác.
- Bộ nhớ: bảng của OpenAI ghi model
turbocần khoảng 6GB VRAM,smallkhoảng 2GB; whisper.cpp ghi bản large cần khoảng 3,9GB RAM, bản small khoảng 852MB. - Một tệp thử ngắn 2–3 phút, giọng nói rõ, để kiểm tra trước khi chạy tệp dài.
Cài FFmpeg theo đúng lệnh trong README của Whisper:
# Ubuntu hoặc Debian
sudo apt update && sudo apt install ffmpeg
# macOS dùng Homebrew
brew install ffmpeg
# Windows dùng Chocolatey
choco install ffmpeg
# Windows dùng Scoop
scoop install ffmpeg
FFmpeg chính thức chỉ phát hành mã nguồn; trang tải của FFmpeg dẫn sang các bản dựng sẵn cho Windows (gyan.dev, BtbN). Bản ổn định mới nhất lúc kiểm tra là 9.0.2. Gõ ffmpeg -version để chắc đã cài xong.
Nguồn: Whisper – cài FFmpeg, bảng model · whisper.cpp – bộ nhớ · FFmpeg – trang tải
Cách 1: openai-whisper, dễ nhất cho người mới
Bước 1. Cài và chạy lệnh đầu tiên
pip install -U openai-whisper
whisper <tên tệp>.mp3 --model turbo --language vi --output_format srt
Lần chạy đầu, model tự tải về thư mục ~/.cache/whisper. Kết quả là tệp .srt cùng tên nằm trong thư mục đang đứng (đổi bằng --output_dir). Mặc định --output_format all xuất mọi định dạng (txt, vtt, srt, tsv, json, jsonl); ghi rõ srt cho gọn.
Bước 2. Chia dòng phụ đề cho dễ đọc
Ba cờ --highlight_words, --max_line_width, --max_line_count chỉ chạy khi bật --word_timestamps True. Lệnh dưới đặt tối đa 42 ký tự mỗi dòng, 2 dòng mỗi khung (hai con số là ví dụ minh hoạ; lệnh ghép từ cú pháp chính thức, hãy thử trên máy thử trước):
whisper <tên tệp>.mp3 --model turbo --language vi --output_format srt --output_dir phude --word_timestamps True --max_line_width 42 --max_line_count 2Bước 3. Gợi ý tên riêng (tuỳ chọn)
Cờ --initial_prompt "…" nhận một đoạn chữ làm lời mồi cho đoạn âm thanh đầu. Bạn có thể thử ghi sẵn tên thương hiệu, tên sản phẩm rồi so kết quả với lần chạy không có lời mồi; hiệu quả tuỳ từng tệp.
turbo không được huấn luyện cho việc dịch: dùng --task translate nó vẫn trả về ngôn ngữ gốc. Nếu cài báo lỗi No module named 'setuptools_rust', chạy pip install setuptools-rust rồi cài lại.Nguồn: Whisper README · Whisper – các cờ
Cách 2: whisper.cpp, nhẹ và không cần Python
Bước 1. Tải mã nguồn, tải model, build
git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp
sh ./models/download-ggml-model.sh large-v3-turbo   # model đa ngôn ngữ, có tiếng Việt
cmake -B build
cmake --build build -j --config Release
Lệnh theo phần bắt đầu nhanh trong README, đổi model mẫu base.en sang large-v3-turbo để có tiếng Việt. Máy yếu có thể chọn bản nén large-v3-turbo-q5_0 hoặc large-v3-turbo-q8_0. Trên Windows, script tải model là .\models\download-ggml-model.cmd kèm tên model.
- Mac chip Apple: dùng GPU qua Metal mặc định, không cần thêm cờ.
- Card NVIDIA: build bằng
cmake -B build -DGGML_CUDA=1rồicmake --build build -j --config Release(card khác:-DGGML_VULKAN=1).
Bước 2. Đổi sang WAV rồi chép lời tiếng Việt
ffmpeg -i <tên tệp>.mp3 -ar 16000 -ac 1 -c:a pcm_s16le output.wav
./build/bin/whisper-cli -m models/ggml-large-v3-turbo.bin -f output.wav -l vi -osrt -of phude
README ghi whisper-cli hiện chạy với tệp WAV 16-bit, nên lệnh FFmpeg ở dòng đầu đổi âm thanh sang 16 kHz, một kênh. Ở dòng hai: -l vi là bắt buộc vì mặc định là en; -osrt xuất SRT (-ovtt, -otxt cho định dạng khác); -of phude là tên tệp ra, không đuôi; -ml giới hạn độ dài mỗi đoạn.
Muốn bỏ bớt khoảng lặng, tải model VAD bằng ./models/download-vad-model.sh silero-v6.2.0 rồi thêm --vad -vm models/ggml-silero-v6.2.0.bin vào lệnh chép lời.
Nguồn: whisper.cpp README · whisper-cli – các cờ · whisper-cli README
Cách 3: faster-whisper cho máy có card NVIDIA
Bước 1. Cài thư viện
pip install faster-whisper
pip install nvidia-cublas-cu12 nvidia-cudnn-cu12==9.*   # chỉ Linux có card NVIDIA, khi máy chưa có thư viện GPU
Bước 2. Lưu đoạn mã ghi SRT
faster-whisper trả về các đoạn lời có giờ bắt đầu, giờ kết thúc nhưng không có hàm xuất SRT sẵn. Đoạn mã dưới dùng đúng lời gọi trong README, thêm vài dòng ghi tệp SRT (ghép từ cú pháp chính thức, hãy thử trên máy thử trước):
from faster_whisper import WhisperModel


def moc(t):
    ms = int(round(t * 1000))
    h, ms = divmod(ms, 3600000)
    m, ms = divmod(ms, 60000)
    s, ms = divmod(ms, 1000)
    return f"{h:02d}:{m:02d}:{s:02d},{ms:03d}"


model = WhisperModel("large-v3-turbo", device="cuda", compute_type="float16")
# Máy không có card NVIDIA: WhisperModel("large-v3-turbo", device="cpu", compute_type="int8")
segments, info = model.transcribe("<tên tệp>.mp3", language="vi", beam_size=5,
                                  vad_filter=True, vad_parameters=dict(min_silence_duration_ms=500))
with open("phude.srt", "w", encoding="utf-8") as f:
    for i, seg in enumerate(segments, start=1):
f.write(f"{i}\n{moc(seg.start)} --> {moc(seg.end)}\n{seg.text.strip()}\n\n")language="vi"ép nhận tiếng Việt;vad_filter=Truebỏ khoảng lặng.- Máy không có card NVIDIA: đổi sang dòng có
device="cpu", compute_type="int8". - Card NVIDIA ít VRAM: thử
compute_type="int8_float16".
Model tải về bộ nhớ đệm Hugging Face nếu không đặt download_root.
Nguồn: faster-whisper README · faster-whisper – tham số transcribe · faster-whisper – tên model
Kiểm tra đã chạy đúng
- Tệp
.srtmở được bằng trình soạn thảo: mỗi khung có số thứ tự, dòng mốc giờ dạng00:00:01,000 --> 00:00:03,500, rồi tới lời thoại. - Chữ là tiếng Việt có dấu, không phải tiếng Anh hay bản dịch.
- Kéo tệp SRT vào trình phát video hoặc CapCut: chữ khớp miệng nói, không lệch dần về cuối.
- Máy có card NVIDIA mà chạy rất chậm: có thể Whisper đang chạy bằng CPU. openai-whisper tự dùng
cudakhi nhận được card (cờ--device); xem thêm mục lỗi bên dưới. - Thử 2–3 model trên cùng một đoạn 3 phút thật của bạn, ghi lại bản nào ít lỗi hơn. Hiện chưa có số đo chính thức so sánh độ chính xác tiếng Việt giữa các model, nên tự thử là cách chắc chắn nhất.
Soát phụ đề trước khi đăng
Phụ đề do máy chép là bản nháp. Một người đọc lại theo thứ tự ưu tiên:
- Tên riêng: thương hiệu, sản phẩm, tên người, địa danh.
- Con số: giá, khuyến mãi, ngày giờ, số điện thoại. Sai ở đây có thể gây hiểu nhầm cho khách.
- Đoạn khó: nói chồng nhau, nhạc nền to, giọng địa phương, từ tiếng Anh xen giữa.
- Độ dài dòng: chia lại dòng quá dài để người xem kịp đọc trên điện thoại.
Quy trình video ngắn đầy đủ (đọc giọng, model video): AI Local cho video và giọng nói.
Lỗi thường gặp và cách xử lý
| Hiện tượng | Nguyên nhân thường gặp | Cách xử lý |
|---|---|---|
Báo không tìm thấy ffmpeg | Chưa cài FFmpeg hoặc chưa mở lại cửa sổ dòng lệnh | Cài theo mục Chuẩn bị, mở lại Terminal, gõ ffmpeg -version |
Cài openai-whisper lỗi setuptools_rust | Gói tiktoken không có bản dựng sẵn cho máy | pip install setuptools-rust; có thể cần cài thêm Rust |
| whisper.cpp ra chữ tiếng Anh | Thiếu -l vi, hoặc dùng model đuôi .en | Thêm -l vi; tải model đa ngôn ngữ như large-v3-turbo |
| whisper.cpp không đọc được tệp | Tệp không phải WAV 16-bit | Đổi bằng lệnh FFmpeg ở cách 2 |
| faster-whisper báo thiếu thư viện CUDA, cuDNN | Máy chưa có CUDA 12, cuDNN 9 | Linux: cài nvidia-cublas-cu12, nvidia-cudnn-cu12==9.* qua pip; hoặc chạy bằng CPU |
| Chạy rất chậm | Đang chạy bằng CPU, hoặc model quá lớn so với máy | Chọn model nhỏ hơn, bản nén q5_0 của whisper.cpp, int8 của faster-whisper |
| Kết quả là bản dịch hoặc sai ngôn ngữ | Để trống ngôn ngữ nên model tự đoán sai | Luôn ghi rõ --language vi, -l vi hoặc language="vi" |
Nguồn: Whisper README · whisper.cpp README · faster-whisper README
Cập nhật và gỡ cài đặt
| Công cụ | Cập nhật | Gỡ |
|---|---|---|
| openai-whisper | pip install -U openai-whisper; README có thêm lệnh lấy bản mới nhất từ GitHub: pip install --upgrade --no-deps --force-reinstall git+https://github.com/openai/whisper.git | pip uninstall openai-whisper, rồi tự xoá thư mục model ~/.cache/whisper |
| whisper.cpp | Lấy mã nguồn bản mới (hiện là v1.9.5) và build lại như bước 1 | Xoá thư mục whisper.cpp (gồm cả model trong models/) |
| faster-whisper | pip install -U faster-whisper | pip uninstall faster-whisper, rồi xoá model trong bộ nhớ đệm Hugging Face nếu cần chỗ |
Lệnh pip cập nhật và gỡ là lệnh chuẩn của Python, README không ghi riêng.
Nguồn: Whisper README · Whisper – thư mục model · whisper.cpp – bản mới nhất
An toàn và dữ liệu
- Bản ghi khách hàng là dữ liệu cá nhân. Chép lời trên máy giúp tệp không rời máy, nhưng bạn vẫn phải lưu trữ, phân quyền và xoá theo quy định bảo vệ dữ liệu cá nhân. Không để tệp ghi âm, phụ đề trong thư mục đồng bộ công khai.
- whisper-server của whisper.cpp mặc định chỉ nghe
127.0.0.1:8080. Giữ nguyên như vậy, không mở cổng ra Internet; cần dùng từ xa thì đi qua VPN, xem truy cập AI Local từ xa qua Tailscale. - Chỉ tải từ nguồn chính thức: GitHub của openai, ggml-org, SYSTRAN; trang ffmpeg.org. Script tải model của whisper.cpp nên mở ra đọc trước khi chạy.
- Giấy phép: ba công cụ dùng MIT; PhoWhisper dùng BSD-3-Clause (giữ ghi công). Đọc điều khoản trước khi dùng cho kinh doanh.
- Không dán khoá, mật khẩu vào lời mồi, ghi chú hay khung chat với AI.
Nguồn: whisper-server · PhoWhisper – giấy phép
Bắt đầu từ đâu?
- Hôm nay: cài FFmpeg và openai-whisper, chạy một tệp 3 phút với
--language vi --output_format srt. - Tuần này: thử thêm whisper.cpp hoặc faster-whisper trên cùng tệp, chọn cách cho kết quả ổn định trên máy của bạn, viết danh sách tên riêng hay sai để người soát đối chiếu.
- Khi làm đều: đặt quy trình cố định: chép lời, một người soát, rồi mới đăng.
Tài liệu nội bộ cũng có thể chạy hoàn toàn trên máy: xem Hỏi đáp tài liệu nội bộ bằng AnythingLLM. Muốn được tư vấn hoặc cài đặt AI Local theo nhu cầu riêng, bạn có thể đăng ký Tư vấn 1-1 hoặc Coaching 1-1 cho doanh nghiệp; chi phí báo sau buổi tư vấn.
Đọc tiếp: Hỏi đáp tài liệu nội bộ →
Câu hỏi thường gặp
Làm phụ đề bằng Whisper trên máy có mất phí không?
Không mất phí phần mềm: openai-whisper, whisper.cpp và faster-whisper đều dùng giấy phép MIT. Bạn chỉ tốn công cài, dung lượng ổ cứng cho model và thời gian máy chạy. Chỉ cần Internet khi cài và tải model lần đầu.
Máy không có card NVIDIA có chạy được không?
Được. whisper.cpp chạy được bằng CPU thuần, trên Mac chip Apple dùng GPU qua Metal mặc định. faster-whisper cũng có chế độ CPU với int8. Máy yếu nên chọn model nhỏ hơn và chấp nhận chờ lâu hơn.
Vì sao whisper.cpp trả ra chữ tiếng Anh dù video nói tiếng Việt?
Vì ngôn ngữ mặc định của whisper-cli là tiếng Anh. Thêm cờ -l vi vào lệnh. Ngoài ra không dùng các model có đuôi .en, vì đó là bản chỉ dành cho tiếng Anh.
Có nên dùng PhoWhisper của VinAI không?
PhoWhisper được tinh chỉnh trên 844 giờ tiếng Việt, giấy phép BSD-3-Clause. Tuy vậy model card không hướng dẫn dùng thẳng với lệnh whisper, whisper.cpp hay faster-whisper; model ở định dạng Transformers nên có thể phải chuyển đổi. Hãy coi đây là phương án để người kỹ thuật thử thêm, không phải bước bắt buộc.
Phụ đề tạo ra có đăng thẳng được không?
Không nên. Hãy coi đó là bản nháp: đọc lại tên riêng, tên sản phẩm, giá, số điện thoại và các đoạn nói chồng nhau trước khi đăng lên YouTube, TikTok hay Facebook.
Tài liệu liên quan
- AI Local · AI AgentAI Local là gì? Chạy AI ngay trên máy tính, không tốn phí APIAI Local là gì: chạy model AI mở ngay trên máy tính của bạn, không trả phí API theo lượt, dữ liệu ở lại máy. Lợi ích, giới hạn, so sánh với AI đám mây.
- AI Local · AI AgentCài Ollama trên Windows có card NVIDIA từng bướcCài Ollama trên Windows có card NVIDIA: kiểm tra driver, cài đặt, dời thư mục model sang ổ khác, đặt biến môi trường, xác nhận chạy GPU, sửa lỗi, cập nhật, gỡ.
- AI Local · AI AgentCấu hình máy tính chạy AI Local: RAM, VRAM, Mac hay PC NVIDIACấu hình máy tính chạy AI Local: RAM, VRAM quyết định model nào chạy được, cách ước tính dung lượng theo Q4/Q8, Mac hay PC NVIDIA, ổ cứng, mua máy hay thuê GPU.
- AI Local · AI AgentCài AI Local trên Mac: Ollama và LM StudioCài AI Local trên Mac từng bước: xác định chip Apple hay Intel, cài Ollama và LM Studio, dời thư mục model, tắt tự chạy, kiểm tra, sửa lỗi, cập nhật, gỡ.
Xem tất cả tài liệu hướng dẫn →
Đăng ký Tư vấn 1-1 về AI Local
Chuyên gia Aduca cùng bạn xem nhu cầu, máy đang có và dữ liệu cần bảo vệ, rồi đề xuất nên chạy AI Local, dùng đám mây hay kết hợp. Dịch vụ cài AI Local nằm trong gói Tư vấn 1-1 hoặc Coaching 1-1; chi phí báo sau buổi tư vấn.
Nguồn tham khảo
- OpenAI Whisper – GitHub (README, giấy phép)
- OpenAI Whisper – các cờ dòng lệnh (transcribe.py)
- whisper.cpp – GitHub (README)
- whisper.cpp – bản phát hành mới nhất
- whisper.cpp – cờ của whisper-cli
- whisper.cpp – whisper-server
- faster-whisper – GitHub (README)
- faster-whisper – tên model nhận
- PhoWhisper – model card (VinAI)
- FFmpeg – trang tải
Lịch sử cập nhật
- 21/10/2026 — Bản đầu.
Miễn trừ trách nhiệm
Bài viết thuộc chuỗi kiến thức của Công ty Cổ phần Giáo dục Aduca, chia sẻ miễn phí cho mục đích học tập. Thông tin kỹ thuật đối chiếu với tài liệu chính thức của các dự án và nền tảng tại ngày cập nhật (có ghi nguồn); phần nhận định là quan điểm của Aduca. OpenClaw, Hermes Agent, Claude (thương hiệu của Anthropic), ChatGPT (thương hiệu của OpenAI), n8n (thương hiệu của n8n GmbH), các phần mềm chạy model và các model AI mở (Ollama, LM Studio, Qwen, Gemma, gpt-oss…), Obsidian, Notion, phương pháp Building a Second Brain (Tiago Forte) cùng các phần mềm, dịch vụ nêu trong bài thuộc về chủ sở hữu tương ứng, không thuộc Aduca; Aduca không phải đối tác chính thức của các công ty này. Tính năng, gói và giá có thể thay đổi bất cứ lúc nào – hãy kiểm tra trang chính thức trước khi mua. Kết quả áp dụng phụ thuộc quy trình, dữ liệu và con người của từng doanh nghiệp; bài viết không cam kết doanh thu hay hiệu quả cụ thể. © 2026 Aduca — được trích dẫn khi ghi rõ nguồn aduca.vn.