Cài AI Local trên Mac: Ollama và LM Studio
Bài thực hành cho người dùng Mac: xác định máy là chip Apple hay Intel, chọn cỡ model theo RAM, cài Ollama và LM Studio, đặt thư mục model (kể cả ổ SSD ngoài), quản lý chạy nền, kiểm tra, sửa lỗi, cập nhật và gỡ. Dữ kiện đối chiếu tài liệu chính thức của Apple, Ollama và LM Studio ngày 20–21/10/2026.
Có MacBook trong tay, nên cài Ollama hay LM Studio?
Bạn dùng một chiếc MacBook 16GB, muốn thử AI chạy ngay trên máy để tóm tắt tài liệu nội bộ mà không gửi dữ liệu lên mạng. Đồng nghiệp dùng Mac Intel đời cũ cũng muốn cài theo. Câu hỏi đầu tiên: cài Ollama hay LM Studio, máy nào chạy được, model cỡ nào là vừa? (Tình huống minh hoạ.)
Bài này đi sâu đúng một nền tảng: macOS. Mỗi bước có lệnh theo tài liệu chính thức và cách tự kiểm tra. Bức tranh chung về các công cụ và Open WebUI ở Cài AI Local trong 30 phút.
Cài AI Local trên Mac gồm những gì?
Cài AI Local trên Mac là xác định chip của máy, cài Ollama (chạy nền, có API) hoặc LM Studio (có giao diện), chọn model vừa với bộ nhớ hợp nhất của Mac, rồi kiểm tra model chạy đúng ngay trên máy.
- Xem chip và RAMAbout This Mac
- Chọn công cụOllama, LM Studio hoặc cả hai
- Cài và chạy thửModel nhỏ trước
- Đặt thư mục, chạy nềnỔ ngoài, Login Items
- Kiểm tra, cập nhật, an toànLệnh kiểm tra, bản vá
Bước 0: Mac của bạn là chip Apple hay Intel
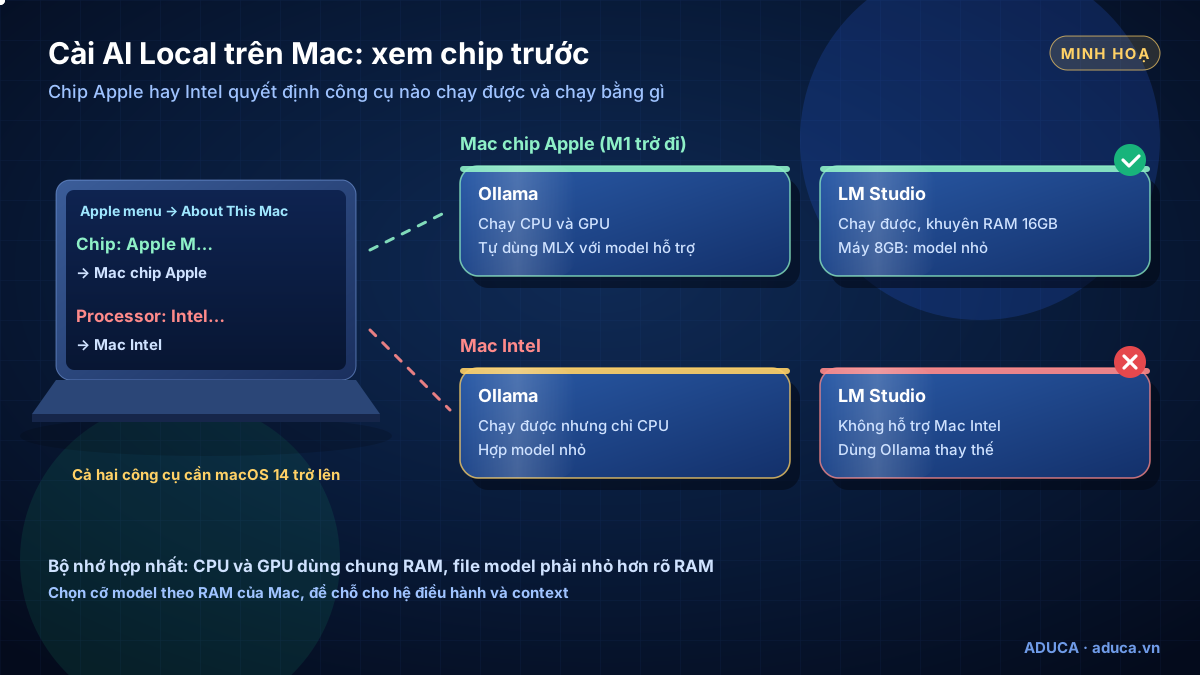
Vào Apple menu → About This Mac. Mac chip Apple hiện mục Chip kèm tên chip; Mac Intel hiện mục Processor kèm tên bộ xử lý Intel. Ở đây cũng có dung lượng bộ nhớ (RAM).
| Mac chip Apple | Mac Intel | |
|---|---|---|
| Ollama (macOS 14+) | Chạy CPU và GPU; từ v0.40.0 tự chạy bằng MLX với model được hỗ trợ | Chạy được, chỉ bằng CPU |
| LM Studio (macOS 14+) | Chạy được; khuyên RAM từ 16GB | Không hỗ trợ |
Mac chip Apple dùng bộ nhớ hợp nhất: CPU và GPU chung một khối RAM, nên RAM chính là giới hạn cỡ model. File model cần nhỏ hơn rõ rệt so với RAM, để còn chỗ cho macOS, ứng dụng khác và context.
| RAM của Mac | Model để thử (dung lượng file trên Ollama, ước tính) |
|---|---|
| 8GB | qwen3.5:4b (3,3–4,0GB), gemma4:e2b-it-qat (4,3GB) |
| 16GB | qwen3.5:9b (6,6–7,6GB), gemma4:12b (7,7–8,0GB) |
| 24–36GB | gemma4:26b (16–19GB), qwen3.8:27b (18GB) |
| 64GB | qwen3.8:27b-q8_0 (30GB), gemma4:31b-it-q8_0 (34GB) |
| 128GB trở lên | gpt-oss:120b (65GB) |
Bảng là ước tính Aduca ghép từ dung lượng file chính thức, không phải số đo tốc độ. Các model trên dùng giấy phép Apache-2.0; vẫn đọc điều khoản trước khi dùng cho kinh doanh. Cách tính chi tiết ở Cấu hình máy tính chạy AI Local.
Nguồn: Apple – Mac có chip Apple · Ollama – macOS · Ollama v0.40.0 · LM Studio – yêu cầu hệ thống · Apple – bộ nhớ hợp nhất · Ollama – qwen3.8 · Ollama – gemma4 · Ollama – gpt-oss
Bước 1: cài Ollama và chạy thử
- Tải
ollama.dmgở trang tải chính thức ollama.com/download/mac, mở tệp, kéo Ollama vào Applications. - Mở ứng dụng. Ollama kiểm tra lệnh
ollamađã có trong PATH chưa; nếu chưa, nó xin quyền tạo liên kết trong/usr/local/bin. Hãy đồng ý để dùng lệnh trong Terminal. - Muốn để ứng dụng ở chỗ khác: từ chối câu hỏi "Move to Applications?" lần đầu, và tự bảo đảm
Ollama.app/Contents/Resources/ollamanằm trong PATH. - Cách khác bằng dòng lệnh (dùng khi máy chưa có lệnh
ollama): lệnh cài chính thức bên dưới.
curl -fsSL https://ollama.com/install.sh | shSau đó tải một model nhỏ để kiểm tra:
ollama -v                 # in phiên bản là đã cài xong
ollama pull qwen3.5:4b    # model nhỏ, khoảng 3,3–4,0GB theo trang Ollama
ollama run qwen3.5:4b     # mở phiên chat với model
ollama ps                 # mở cửa sổ Terminal thứ hai, chạy khi model đang nạp
Hỏi vài câu thật của doanh nghiệp để tự đánh giá tiếng Việt; điểm số chung trên mạng chưa nói được model có hợp việc của bạn hay không, cách tự chấm có ở Bộ đề tự chấm model AI tiếng Việt.
Nguồn: Ollama – macOS · Ollama – Tải cho Mac · Ollama CLI · Ollama – qwen3.5
Bước 2: thư mục model, ổ SSD ngoài và chạy nền
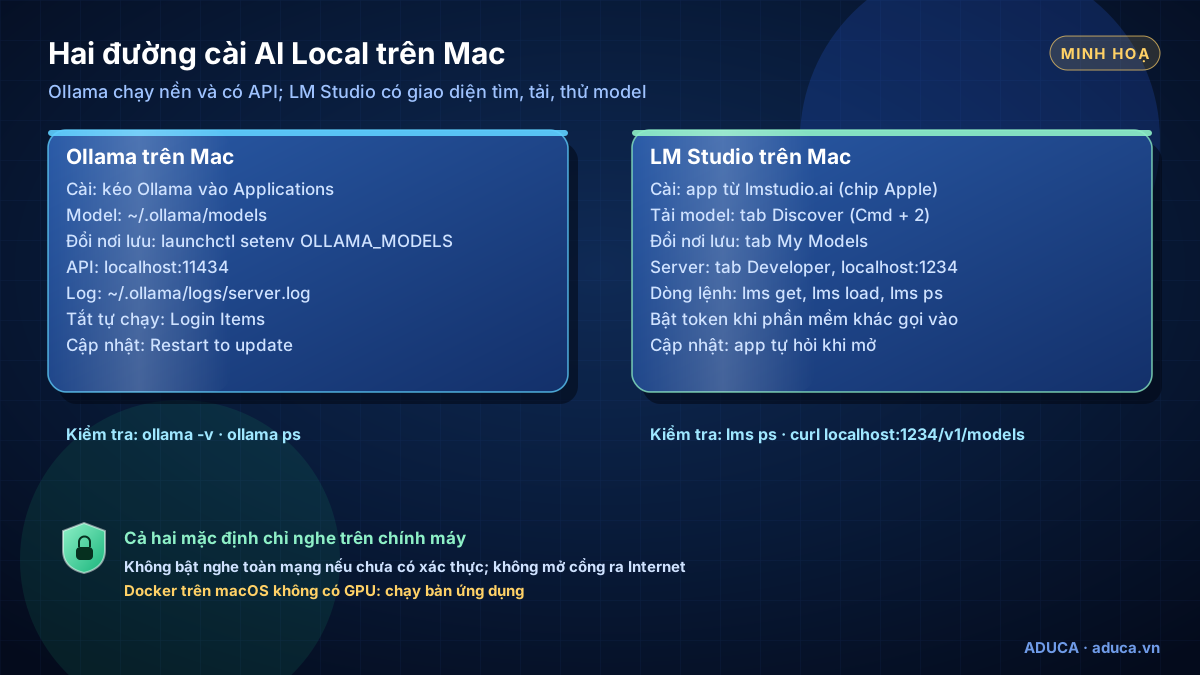
~/.ollamachứa model và cấu hình;~/.ollama/logschứa log (app.log,server.log).- Dời model sang ổ khác (ví dụ SSD ngoài): đặt biến
OLLAMA_MODELSbằnglaunchctl setenvnhư lệnh dưới, rồi thoát và mở lại ứng dụng Ollama. Gợi ý: cắm ổ trước khi mở Ollama. - Cùng cách này đặt các biến khác, ví dụ
OLLAMA_CONTEXT_LENGTHcho tài liệu dài (giải thích ở bài tổng quan). - Tắt tự chạy khi đăng nhập: System Settings → tìm "Login Items" → mục
Ollamadưới "Allow in the Background" → gạt tắt. - Không chạy Ollama trong Docker trên Mac: Docker Desktop trên macOS không có tăng tốc GPU.
launchctl setenv OLLAMA_MODELS "<đường dẫn thư mục, ví dụ /Volumes/SSD/ollama-models>"
cat ~/.ollama/logs/server.log    # xem log khi cần kiểm tra
Nguồn: Ollama – macOS · Ollama FAQ – biến môi trường, Login Items, Docker · Ollama – Troubleshooting
Bước 3: cài LM Studio và dùng lệnh lms
- Tải ứng dụng ở lmstudio.ai/download (bản cho Mac chip Apple) và cài như ứng dụng Mac thông thường.
- Tìm model ở tab Discover (phím tắt Cmd + 2): gõ từ khoá như
qwen,gemma. Mỗi model có nhiều bản nén ghi mã Q; tài liệu khuyên chọn bản 4-bit trở lên nếu máy đủ sức. - Đổi thư mục lưu model (mặc định
~/.lmstudio/models) ở tab My Models. - Muốn phần mềm khác gọi vào: bật Start server ở tab Developer, địa chỉ mặc định
http://localhost:1234.
LM Studio kèm công cụ dòng lệnh lms, dùng được sau khi mở ứng dụng ít nhất một lần (nếu lệnh không chạy: npx lmstudio install-cli). Trên Mac chip Apple, có thể tải riêng bản MLX:
lms ls                                         # model đã tải
lms get <tên model> --mlx                    # tìm và tải bản định dạng MLX
lms load --estimate-only <model_key>         # ước tính bộ nhớ trước khi nạp
lms load <model_key> --context-length 8192   # nạp model với context 8192 token
lms ps                                         # model đang nạp
lms unload --all                               # giải phóng bộ nhớ
Lệnh lms load --estimate-only cho biết model cần bao nhiêu bộ nhớ trước khi nạp, rất hợp khi Mac chỉ có 8–16GB. Cách dùng LM Studio làm máy chủ cho phần mềm khác ở Dùng LM Studio làm máy chủ AI.
Nguồn: LM Studio – Tải · LM Studio – Tải model · LM Studio – Thư mục model · LM Studio – lms · lms get · lms load · LM Studio – Server
Kiểm tra đã chạy đúng
-
ollama -vin ra phiên bản; bản ổn định mới nhất khi kiểm tra là v0.40.6. - Khi model đang nạp,
ollama pscột PROCESSOR báo GPU trên Mac chip Apple; báo100% CPUlà đang chạy bằng CPU (bình thường với Mac Intel). - LM Studio:
lms psthấy model đang nạp; khi bật server, ba lệnh dưới trả về trạng thái chạy và danh sách model.
lms server start
lms server status --json --quiet    # kết quả dạng { "running": true, "port": 1234 }
curl http://localhost:1234/v1/models
Nguồn: Ollama FAQ – ollama ps · Ollama Releases · lms server status · LM Studio – OpenAI compat
Lỗi thường gặp và cách xử lý
| Hiện tượng | Nguyên nhân thường gặp | Cách xử lý |
|---|---|---|
| Không cài hoặc không mở được LM Studio | Mac Intel, hoặc macOS cũ hơn 14 | Dùng Ollama; cập nhật macOS nếu máy hỗ trợ |
Terminal báo không có lệnh ollama | Chưa đồng ý tạo liên kết trong /usr/local/bin | Mở lại ứng dụng Ollama và đồng ý, hoặc đưa đường dẫn lệnh vào PATH |
| Mac chip Apple nhưng Ollama chỉ chạy CPU | Chạy qua Rosetta (giả lập x86) hoặc trong Docker | Dùng bản ứng dụng tải từ trang chính thức, chạy trực tiếp |
| Máy chậm hẳn, ứng dụng khác giật | Model hoặc context quá lớn so với RAM | Chọn model nhỏ hơn; thử lms load --estimate-only trước khi nạp |
| Model "biến mất" sau khi dời ra SSD ngoài | Ổ chưa cắm khi mở ứng dụng, hoặc biến chưa nhận | Cắm ổ, đặt lại biến, thoát và mở lại ứng dụng |
Lệnh lms không chạy | Chưa mở LM Studio lần nào | Mở ứng dụng một lần, hoặc npx lmstudio install-cli |
Xem log Ollama bằng cat ~/.ollama/logs/server.log. Với LM Studio, có thể theo dõi log máy chủ bằng lms log stream --source server; báo lỗi ở kho bug tracker chính thức trên GitHub.
Nguồn: Ollama – Troubleshooting · Ollama – macOS · LM Studio – yêu cầu hệ thống · lms log stream · LM Studio bug tracker
Cập nhật và gỡ cài đặt
Ollama
Ollama tự tải bản cập nhật; bấm biểu tượng trên thanh menu → Restart to update. Từ v0.40.2, model tải bằng bản cũ được nâng cấp ở lần chạy đầu và bản gốc được giữ làm dự phòng, nên ổ đĩa tạm tốn thêm; ghi chú phát hành v0.40.2 có cách xoá. Gỡ hẳn theo tài liệu Ollama:
sudo rm -rf /Applications/Ollama.app
sudo rm /usr/local/bin/ollama
rm -rf "$HOME/Library/Application Support/Ollama"
rm -rf "$HOME/Library/Saved Application State/com.electron.ollama.savedState"
rm -rf ~/Library/Caches/com.electron.ollama/
rm -rf ~/Library/Caches/ollama
rm -rf ~/Library/WebKit/com.electron.ollama
rm -rf ~/.ollama # XOÁ TOÀN BỘ MODEL; bỏ dòng này nếu muốn giữrm -rf xoá vĩnh viễn, không qua Thùng rác. Dòng cuối xoá toàn bộ model trong ~/.ollama; nếu đã dời model ra ổ khác, thư mục đó phải tự xoá. Tài liệu gốc để hai đường dẫn có dấu cách trong ngoặc kép dạng "~/..."; trong ngoặc kép, Terminal không hiểu dấu ~, nên bài đã đổi thành "$HOME/...".LM Studio
Ứng dụng tự kiểm tra bản mới khi mở và hỏi cập nhật ngay hay để sau; bản mới nhất khi kiểm tra là 0.4.26 (13/10/2026). Thành phần chạy model cập nhật riêng bằng lms runtime update. Khi kiểm tra, tài liệu LM Studio không có trang hướng dẫn gỡ cài đặt riêng; gỡ như ứng dụng Mac thông thường theo hướng dẫn của Apple (kéo từ Applications vào Thùng rác), rồi tự xử lý thư mục model ở ~/.lmstudio/models hoặc thư mục bạn đã đổi.
Nguồn: Ollama FAQ – cập nhật · Ollama – gỡ trên macOS · Ollama v0.40.2 · LM Studio changelog · LM Studio – cập nhật · lms runtime · Apple – gỡ ứng dụng
An toàn khi chạy AI Local trên Mac
- Ollama chỉ nghe trên chính máy (
127.0.0.1:11434) và API không có xác thực. Đặtlaunchctl setenv OLLAMA_HOST "0.0.0.0:11434"là mọi máy trong mạng gọi được; chỉ làm khi thật cần, không mở ra Internet. - LM Studio mặc định không yêu cầu xác thực. Tuỳ chọn Serve on Local Network mở máy chủ ra mạng; tài liệu khuyên bật xác thực: Server Settings → Manage Tokens → Create Token. Token chỉ hiện một lần: lưu vào trình quản lý mật khẩu, không dán vào chat hay prompt.
- Biết khi nào dữ liệu rời máy: model cloud và tìm web của Ollama chạy trên máy chủ Ollama; tắt hẳn bằng
launchctl setenv OLLAMA_NO_CLOUD 1rồi mở lại ứng dụng (ghép từ cú pháp chính thức, hãy thử trên máy thử trước). - Cập nhật bản vá cho cả hai ứng dụng; chỉ tải model từ nguồn tin cậy.
- Làm việc từ xa: đi qua VPN, xem Truy cập AI Local từ xa qua Tailscale.
Nguồn: Ollama FAQ – mạng, cloud · LM Studio – xác thực · LM Studio – Serve on Local Network
Bắt đầu từ đâu?
- Hôm nay: xem chip và RAM trong About This Mac, cài Ollama hoặc LM Studio, chạy thử một model nhỏ.
- Tuần này: thử một model vừa RAM theo bảng, dời thư mục model nếu ổ trong nhỏ, ghi lại model nào trả lời tiếng Việt đúng ý cho từng việc.
- Khi cần dùng chung: dựng Open WebUI cho cả nhóm hoặc cho n8n gọi vào theo Ghép n8n với Ollama làm chatbot. Máy Windows có card NVIDIA xem Cài Ollama trên Windows có card NVIDIA.
Muốn được tư vấn hoặc cài đặt AI Local theo nhu cầu riêng, bạn có thể đăng ký Tư vấn 1-1 hoặc Coaching 1-1 cho doanh nghiệp; chi phí báo sau buổi tư vấn.
Đọc tiếp: LM Studio làm máy chủ →
Câu hỏi thường gặp
Mac Intel có chạy được AI Local không?
Được với Ollama, nhưng chỉ bằng CPU nên hợp model nhỏ. LM Studio ghi rõ chưa hỗ trợ Mac Intel. Cả hai đều cần macOS 14 Sonoma trở lên.
MacBook 8GB RAM nên chạy model nào?
Model nhỏ, file khoảng 4GB trở xuống, ví dụ qwen3.5:4b hoặc gemma4:e2b-it-qat trên Ollama. LM Studio khuyên từ 16GB và ghi máy 8GB nên dùng model nhỏ với context vừa phải.
Có nên cài cả Ollama và LM Studio trên cùng một Mac?
Được. Ollama hợp khi cần chạy nền và cho phần mềm khác gọi vào; LM Studio hợp để tìm, tải, so model bằng giao diện. Mỗi bên giữ thư mục model riêng, nên để ý dung lượng ổ.
Lưu model ra ổ SSD ngoài được không?
Được với cả hai. Ollama: đặt biến OLLAMA_MODELS bằng launchctl setenv rồi mở lại app. LM Studio: đổi thư mục ở tab My Models. Hãy cắm ổ trước khi mở ứng dụng.
Chạy Ollama trong Docker trên Mac có nhanh hơn không?
Không. Theo tài liệu Ollama, Docker Desktop trên macOS không có tăng tốc GPU, nên trên Mac hãy chạy bản ứng dụng.
Tài liệu liên quan
- AI Local · AI AgentAI Local là gì? Chạy AI ngay trên máy tính, không tốn phí APIAI Local là gì: chạy model AI mở ngay trên máy tính của bạn, không trả phí API theo lượt, dữ liệu ở lại máy. Lợi ích, giới hạn, so sánh với AI đám mây.
- AI Local · AI AgentCài Ollama trên Windows có card NVIDIA từng bướcCài Ollama trên Windows có card NVIDIA: kiểm tra driver, cài đặt, dời thư mục model sang ổ khác, đặt biến môi trường, xác nhận chạy GPU, sửa lỗi, cập nhật, gỡ.
- AI Local · AI AgentCấu hình máy tính chạy AI Local: RAM, VRAM, Mac hay PC NVIDIACấu hình máy tính chạy AI Local: RAM, VRAM quyết định model nào chạy được, cách ước tính dung lượng theo Q4/Q8, Mac hay PC NVIDIA, ổ cứng, mua máy hay thuê GPU.
- AI Local · AI AgentBản đồ model AI mở 2026: chọn model theo việc và theo máyBản đồ model AI mở 2026: Qwen, Gemma 4, gpt-oss, Llama 4, Mistral, GLM, DeepSeek, Phi; cỡ, MoE hay dense, giấy phép thương mại, tag Ollama, tự thử tiếng Việt.
Xem tất cả tài liệu hướng dẫn →
Đăng ký Tư vấn 1-1 về AI Local
Chuyên gia Aduca cùng bạn xem nhu cầu, máy đang có và dữ liệu cần bảo vệ, rồi đề xuất nên chạy AI Local, dùng đám mây hay kết hợp. Dịch vụ cài AI Local nằm trong gói Tư vấn 1-1 hoặc Coaching 1-1; chi phí báo sau buổi tư vấn.
Nguồn tham khảo
- Apple Support – Mac có chip Apple
- Ollama Docs – macOS
- Ollama Docs – FAQ (biến môi trường, Login Items, Docker)
- Ollama Docs – Troubleshooting
- Ollama v0.40.0 – MLX mặc định trên chip Apple
- LM Studio Docs – Yêu cầu hệ thống
- LM Studio Docs – Tải model
- LM Studio Docs – Dòng lệnh lms
- LM Studio Docs – Xác thực
- Apple – Cài và gỡ ứng dụng trên Mac
Lịch sử cập nhật
- 21/10/2026 — Bản đầu.
Miễn trừ trách nhiệm
Bài viết thuộc chuỗi kiến thức của Công ty Cổ phần Giáo dục Aduca, chia sẻ miễn phí cho mục đích học tập. Thông tin kỹ thuật đối chiếu với tài liệu chính thức của các dự án và nền tảng tại ngày cập nhật (có ghi nguồn); phần nhận định là quan điểm của Aduca. OpenClaw, Hermes Agent, Claude (thương hiệu của Anthropic), ChatGPT (thương hiệu của OpenAI), n8n (thương hiệu của n8n GmbH), các phần mềm chạy model và các model AI mở (Ollama, LM Studio, Qwen, Gemma, gpt-oss…), Obsidian, Notion, phương pháp Building a Second Brain (Tiago Forte) cùng các phần mềm, dịch vụ nêu trong bài thuộc về chủ sở hữu tương ứng, không thuộc Aduca; Aduca không phải đối tác chính thức của các công ty này. Tính năng, gói và giá có thể thay đổi bất cứ lúc nào – hãy kiểm tra trang chính thức trước khi mua. Kết quả áp dụng phụ thuộc quy trình, dữ liệu và con người của từng doanh nghiệp; bài viết không cam kết doanh thu hay hiệu quả cụ thể. © 2026 Aduca — được trích dẫn khi ghi rõ nguồn aduca.vn.