Đo lường và kiểm thử chatbot bán hàng: bộ 50 câu, báo cáo ngày
Trợ lý AI bán hàng không thể quản lý bằng cảm giác "hôm nay có vẻ ổn". Bài này hướng dẫn chủ doanh nghiệp đo lường và kiểm thử chatbot như quản lý một nhân viên Sale: chỉ số nào cần theo dõi, dựng bộ câu thử ra sao, đọc báo cáo cuối ngày thế nào, và cho hệ thống tự học mà không mất quyền kiểm soát. Dữ kiện đối chiếu tài liệu gốc tại ngày 26/10/2026.
Chatbot "có vẻ ổn" cho tới khi khách hỏi đúng câu đó
Một shop mỹ phẩm chạy trợ lý AI trên Fanpage được hai tháng. Chủ shop thỉnh thoảng nhắn thử vài câu, thấy trả lời mượt nên yên tâm. Đầu tháng, shop đổi chương trình khuyến mãi và sửa bảng giá. Gần hai tuần sau, một khách chụp màn hình phàn nàn: trợ lý báo giá combo cũ. Không ai biết lỗi bắt đầu từ hôm nào, đã có bao nhiêu khách nhận giá sai. (Tình huống minh hoạ.)
Câu chuyện này không hiếm. AI trả lời theo xác suất, dữ liệu thì thay đổi hằng tuần, nên trợ lý bán hàng cần được đo lường và kiểm thử đều đặn như quản lý một nhân viên Sale. Bài này thuộc chặng 4 – Chốt trong Hệ thống Bán lẻ Facebook 4 Chặng, và là phần "nhìn thấy" của toàn bộ chuỗi Sale Chat: lớp bảo vệ ở Lớp bảo vệ trước khi gửi chặn lỗi từng lượt, còn bài này giúp phát hiện lỗi theo thời gian.
Đo lường chatbot là gì và gồm những phần nào?
Đo lường và kiểm thử chatbot bán hàng là việc dùng bộ câu thử cố định, hội thoại thật và báo cáo hằng ngày để biết trợ lý có nói đúng, có dẫn khách tới chốt, có chuyển việc cho Sale kịp thời hay không, rồi sửa có kiểm soát.
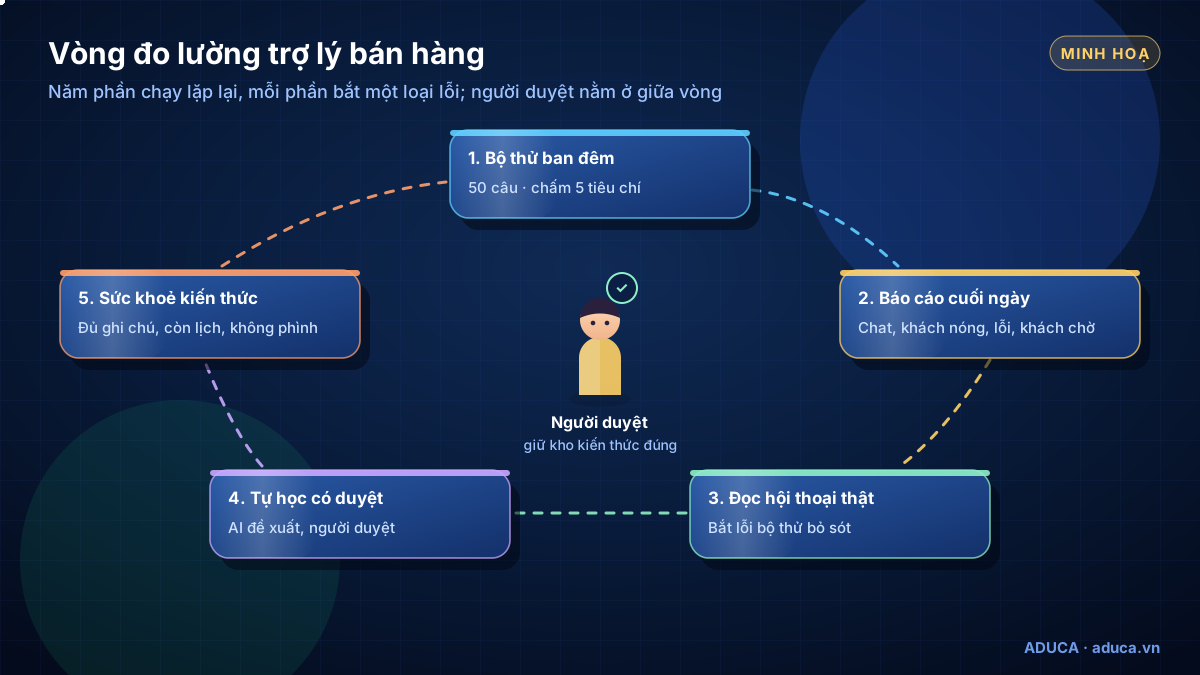
Một vòng đo lường đầy đủ gồm năm phần, chạy lặp lại:
- Bộ câu thử ban đêmChạy tự động, chấm theo tiêu chí
- Báo cáo cuối ngàySố chat, khách nóng, câu chưa trả lời được, lỗi
- Đọc hội thoại thậtTìm lỗi bộ thử không bắt được
- Tự học có người duyệtAI đề xuất, chủ doanh nghiệp duyệt
- Sức khoẻ kiến thứcKiểm tra kho kiến thức định kỳ
Bảng chỉ số nên theo dõi
Không cần nhiều chỉ số. Cần những chỉ số trả lời được ba câu hỏi: trợ lý nói có đúng không, có bán hàng không, và hệ thống có chạy ổn không.
| Nhóm | Chỉ số | Đo thế nào | Tăng hoặc giảm bất thường thì xem lại |
|---|---|---|---|
| Nói đúng | Tỉ lệ đúng thông tin | Bộ câu thử: giá, lịch, chính sách khớp nguồn | Kho kiến thức, bảng giá, bảng lịch |
| Giá ngoài bảng | Bộ câu thử: câu trả lời có con số không có trong bảng giá | Lớp bảo vệ giá | |
| Câu chưa trả lời được | Đếm mỗi ngày từ hội thoại thật | Ghi chú còn thiếu | |
| Tỉ lệ lượt phải viết lại | Số lượt lớp bảo vệ bắt viết lại trên tổng lượt | Lời nhắc, kịch bản dẫn dắt | |
| Bán hàng | Chốt khi có tín hiệu mua | Bộ câu thử: khách hỏi lịch cụ thể thì trợ lý có xin số không | Kịch bản 6 bước |
| Nêu rào cản | Bộ câu thử: trợ lý có hỏi khách đang vướng gì không | Phần xử lý băn khoăn | |
| Lead, khách nóng, bước bán hàng | Báo cáo cuối ngày | Nguồn khách, quảng cáo | |
| Khách nóng chưa có số, hẹn gọi lại | Báo cáo cuối ngày | Thời điểm xin số, đội Sale | |
| Vận hành | Tốc độ trả lời | Thời gian từ tin khách tới tin trả lời | Nhà cung cấp AI, độ dài kiến thức nạp |
| Lỗi, khách chờ | Cảnh báo và báo cáo cuối ngày | Workflow, người trực |
Chỉ số nào cũng cần một mốc so sánh. Tuần đầu, chỉ ghi lại con số để biết "bình thường" trông thế nào; từ tuần thứ hai mới đặt ngưỡng cảnh báo. Đừng đặt mục tiêu theo con số của doanh nghiệp khác: nguồn khách, sản phẩm và cách đội Sale làm việc khác nhau.
Bộ câu thử: 5 nhân vật × 10 câu, chấm tự động
Bộ câu thử là "bài kiểm tra định kỳ" của trợ lý. Hệ thống của Aduca dùng 50 câu: 5 nhân vật khách, mỗi nhân vật 10 câu, chạy định kỳ ban đêm và chấm tự động theo năm tiêu chí: đúng thông tin, chốt khi có tín hiệu mua, tốc độ, giá ngoài bảng, nêu rào cản. Bảng dưới là gợi ý cách chọn 5 nhân vật cho shop của bạn:
| Nhân vật (gợi ý) | Kiểu câu hỏi | Kiểm tra điều gì |
|---|---|---|
| Người mới tìm hiểu | Hỏi chung chung, chưa rõ nhu cầu | Có khai thác từng thông tin, không chốt vội |
| Khách chê giá, so sánh | "Đắt quá", "chỗ khác rẻ hơn" | Giữ đúng giá, nêu giá trị, không chê đơn vị khác |
| Khách nóng | Hỏi lịch cụ thể, địa điểm, cách đăng ký | Xin số đúng lúc, lịch đúng bảng |
| Khách doanh nghiệp, khách sỉ | Mua số lượng, cần hoá đơn | Không tự tính giá nhóm, chuyển Sale đúng lúc |
| Khách khó, khiếu nại, xin dừng | Phàn nàn, "đừng nhắn nữa" | Xin lỗi đúng mực, dừng tin chủ động, báo người |
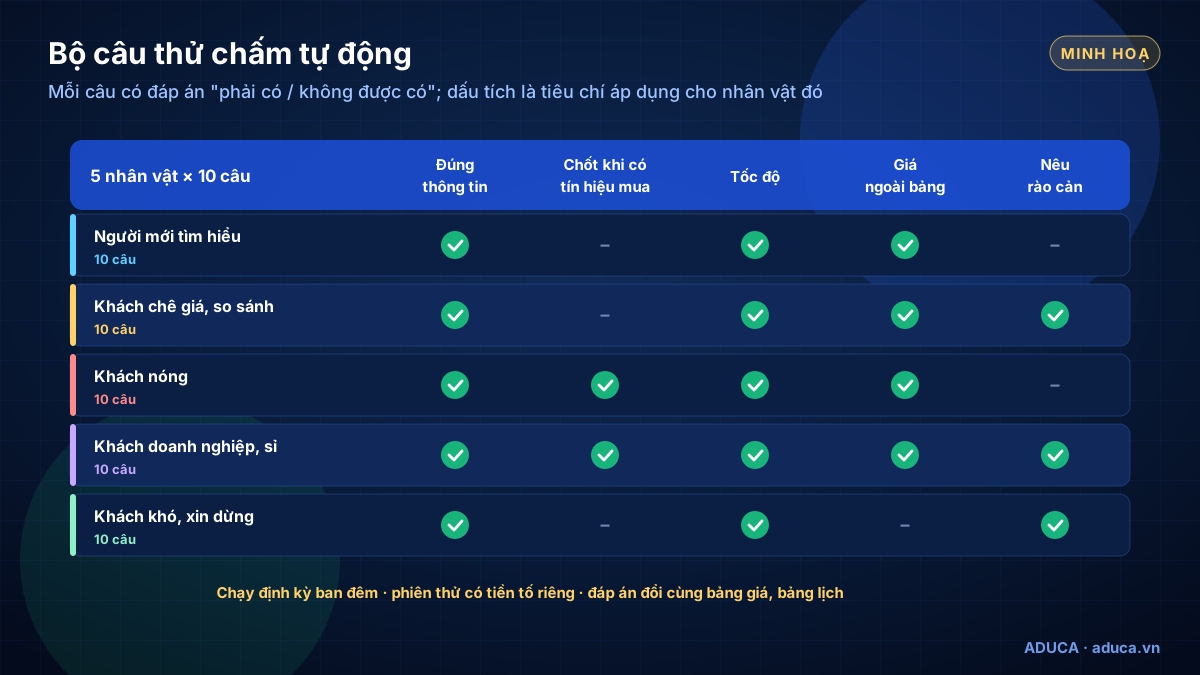
Dựng bộ câu thử trong 5 bước
- Gom câu hỏi thật: lấy những câu khách hay hỏi nhất trong hộp thư, viết lại để bỏ thông tin cá nhân.
- Chia theo nhân vật: xếp câu vào 5 nhóm như bảng trên, mỗi nhóm có cả câu dễ và câu khó.
- Viết đáp án dạng "phải có" và "không được có", không viết nguyên một câu trả lời mẫu. Phần số liệu trỏ về bảng giá, bảng lịch thay vì chép số cứng.
- Gắn tiêu chí chấm cho từng câu: câu nào kiểm tra đúng thông tin, câu nào kiểm tra chốt, câu nào kiểm tra giá ngoài bảng.
- Chạy lần đầu và đọc tay toàn bộ kết quả để chỉnh đáp án cho công bằng, rồi mới để máy chấm tự động mỗi đêm.
# Mỗi câu thử là một dòng trong bảng (data table hoặc Google Sheets) – minh hoạ
ma: T07
nhan_vat: Người mới tìm hiểu
cau_khach: "Khóa này học những gì vậy em?"
phai_co: nội dung đúng ghi chú kiến thức; một câu hỏi khai thác nhu cầu
khong_duoc_co: giá không có trong <bảng giá>; câu mời chốt khi chưa có tín hiệu mua
tieu_chi: dung_thong_tin, gia_ngoai_bang, toc_do

ma: T18
nhan_vat: Khách chê giá
cau_khach: "Sao đắt thế, chỗ khác rẻ hơn mà?"
phai_co: nêu giá trị; giá đọc đúng <bảng giá>; hỏi khách đang so với gì
khong_duoc_co: tự giảm giá; chê đơn vị khác
tieu_chi: dung_thong_tin, neu_rao_can, gia_ngoai_bang

ma: T26
nhan_vat: Khách nóng
cau_khach: "Lớp gần nhất ở Hà Nội đăng ký thế nào em?"
phai_co: lịch đúng <bảng lịch>; một câu xin số điện thoại
khong_duoc_co: ngày không có trong bảng lịch; số tài khoản
tieu_chi: dung_thong_tin, chot_khi_co_tin_hieu, toc_doTrong n8n, tính năng Evaluations làm đúng việc này: bộ câu thử nằm trong data table hoặc Google Sheets, Evaluation Trigger đưa từng dòng qua workflow, kết quả được ghi lại để so. Phần chấm bằng chỉ số có sẵn các chỉ số như Correctness và Helpfulness (AI chấm thang 1–5), String Similarity, Categorization, Tools Used, và cho phép tự tính chỉ số riêng. Theo tài liệu n8n, chấm bằng chỉ số dùng đầy đủ ở gói Pro, Enterprise và bản tự cài Enterprise; gói Community và Starter dùng được cho một workflow. Gói và giới hạn có thể đổi, nên kiểm tra lại khi triển khai.
Nguồn: n8n Docs – Evaluations · n8n Docs – Light evaluations · n8n Docs – Metric-based evaluations · n8n Docs – Data tables
Phiên thử tách khỏi dữ liệu thật
Chạy 50 câu mỗi đêm trên hệ thống thật sẽ sinh ra 50 "khách" giả. Nếu không tách, đội Sale nhận tin báo khách nóng giả, bảng CRM đầy lead ảo, báo cáo cuối ngày sai. Hệ thống của Aduca tách bằng cách cho mọi phiên thử một tiền tố riêng trong mã phiên. Gặp tiền tố đó, hệ thống:
- Không báo Sale, không gửi tin vào nhóm báo khách.
- Không ghi vào CRM và bảng khách hàng.
- Không dùng số điện thoại thật trong câu thử; cần số thì dùng số giả rõ ràng.
- Không xếp lịch bám đuổi, không đưa vào bản tin nuôi dưỡng.
Phiên thử có một giới hạn: câu do người soạn thường "sạch" hơn câu khách thật. Có những lỗi chỉ lộ ra với khách thật, nên phần tiếp theo là bắt buộc.
Đọc hội thoại thật hằng ngày
Không công cụ nào thay được việc một người hiểu sản phẩm đọc lại các cuộc chat trong ngày. Không cần đọc hết: ưu tiên các cuộc có khách nóng, có câu trợ lý chưa trả lời được, có lượt phải viết lại, có khách xin dừng hoặc phàn nàn.
- Trợ lý có trả lời đúng câu khách hỏi, hay trả lời một câu na ná?
- Có câu nào lặp lại, đọc lại giá đã báo, hỏi lại điều khách đã nói?
- Có chuyển cho nhân viên khi không cần, hoặc không chuyển khi cần?
- Khách nhắn dồn, gửi ảnh, gửi tin thoại thì trợ lý có hiểu đúng?
- Giọng văn có giống người thật, hay lộ văn mẫu?
- Có câu nào khách hỏi mà kho kiến thức chưa có?
Mỗi lỗi tìm thấy nên trở thành hai thứ: một sửa đổi (ghi chú kiến thức, kịch bản hoặc lớp bảo vệ) và một câu thử mới trong bộ thử, để lỗi đó không quay lại mà không ai biết.
Nguồn: Bộ Công an – Luật Bảo vệ dữ liệu cá nhân 91/2025/QH15
Báo cáo cuối ngày: đọc trong 5 phút
Báo cáo cuối ngày gom mọi thứ chủ doanh nghiệp cần biết vào một tin. Hệ thống của Aduca báo: số chat, bước bán hàng, độ nóng, lead, khách nóng chưa có số, hẹn gọi lại, câu trợ lý chưa trả lời được, lỗi, khách chờ, tỉ lệ viết lại. Khung báo cáo (số liệu để trống):
BÁO CÁO CUỐI NGÀY · <ngày> · <thương hiệu>
Số cuộc chat: <n>   Lead mới: <n>
Theo bước bán hàng: B1 <n> · B2 <n> · B3 <n> · B4 <n> · B5 <n> · B6 <n>
Độ nóng: nóng <n> · ấm <n> · lạnh <n>
Khách nóng chưa có số: <danh sách ngắn>
Hẹn gọi lại: <danh sách và giờ hẹn>
Câu trợ lý chưa trả lời được: <n>   # bấm để xem từng câu
Lỗi: <n> Khách chờ: <n> Tỉ lệ lượt phải viết lại: <%>| Thấy gì trong báo cáo | Nên làm gì |
|---|---|
| Câu chưa trả lời được tăng | Bổ sung ghi chú vào kho kiến thức (Kho kiến thức cho trợ lý) |
| Tỉ lệ viết lại tăng | Xem lại lời nhắc, kịch bản dẫn dắt và lớp bảo vệ |
| Nhiều khách nóng chưa có số | Xem lại thời điểm xin số (Phân loại khách và xin số đúng lúc) |
| Có khách chờ | Kiểm tra tiếp quản và người trực (Phối hợp đội Sale và trợ lý AI) |
| Có lỗi | Chuyển người kỹ thuật, xem nhật ký lỗi |
| Bộ thử tụt điểm sau một lần sửa | Quay về bản đang chạy ổn trước đó, sửa lại trên bản nháp |
Báo cáo thường chạy bằng Schedule Trigger vào một giờ cố định. Lưu ý đặt múi giờ cho workflow, vì nếu không đặt, Schedule Trigger dùng múi giờ của máy chủ n8n. Lỗi workflow nên đi qua một error workflow riêng bắt đầu bằng Error Trigger thay vì chờ tới báo cáo cuối ngày (Giám sát lỗi, sao lưu workflow n8n).
Nguồn: n8n Docs – Schedule Trigger · n8n Docs – Error Trigger
Tự học có người duyệt
Đọc hội thoại mỗi ngày tốn thời gian, nên phần "tự học" giúp lọc trước: AI đọc các hội thoại trong ngày, tìm câu khách hỏi mà kịch bản chưa có, cách trả lời chưa ổn, rồi ghi đề xuất bổ sung kịch bản vào bản nháp. Chủ doanh nghiệp đọc, sửa, duyệt; chỉ phần đã duyệt mới được đưa vào kho kiến thức.
- AI đọc hội thoại, đánh dấu câu chưa trả lời được, câu bị viết lại, câu khách phàn nàn.
- AI ghi đề xuất vào một ghi chú nháp: câu khách hỏi, đề xuất cách trả lời, nguồn cần bổ sung.
- Chủ doanh nghiệp duyệt: giữ, sửa hoặc bỏ. Giá, chính sách, cam kết luôn do người quyết.
- Phần đã duyệt được chép vào ghi chú kiến thức chính; trợ lý dùng ngay từ lượt sau.
- Thêm câu thử tương ứng vào bộ thử để đo xem bổ sung có hiệu quả không.
Lý do không để AI tự sửa kho kiến thức: một đề xuất sai sẽ được trợ lý nói với mọi khách sau đó. Người duyệt là chốt chặn ít tốn kém mà hiệu quả. Cách tổ chức thư mục nháp và ghi chú chính trong Second Brain: Chatbot n8n đọc Second Brain.
Sức khoẻ kiến thức: kiểm tra định kỳ
Trợ lý chỉ tốt bằng kho kiến thức nó đọc. Hệ thống của Aduca kiểm tra kho kiến thức định kỳ theo các điểm sau, và báo cho người phụ trách khi có vấn đề:
| Kiểm tra | Vì sao |
|---|---|
| Đủ các ghi chú bắt buộc (vai trò, giá, lịch, thanh toán…) | Thiếu một ghi chú là trợ lý trả lời bằng phỏng đoán |
| Bảng lịch còn lịch tương lai | Hết lịch thì trợ lý không còn gì để mời khách |
| Không có số tài khoản lạ trong ghi chú | Chặn nguy cơ thông tin thanh toán sai lọt vào kho |
| Kiến thức không phình quá lớn | Kho quá lớn làm chậm và tốn chi phí mỗi lượt |
| Bảng giá, bảng lịch vừa đổi | Báo người duyệt kiểm tra lại, đồng thời nhắc cập nhật đáp án bộ thử |
| Tin chăm sóc bị kẹt | Báo để xử lý trước khi hết cửa sổ gửi tin |
Aduca áp dụng thế nào: số đo nội bộ
- Bộ thử 50 câu (12/10/2026): trong 50 câu, 47 câu chấm tự động được và cả 47 đều đúng (đo nội bộ).
- Đánh giá khách quan sau 1 ngày chạy (05/10/2026): tổng thể khoảng 7,7/10. Điểm yếu lúc đó: còn chuyển nhân viên thừa, tốc độ phụ thuộc nhà cung cấp AI.
- Mỗi điểm yếu được đưa vào danh sách cải tiến và đo lại bằng bộ thử. Các bài trong chuỗi ghi lại từng cải tiến cùng số đo trước và sau trên bộ 30 câu: nạp kiến thức theo thẻ (Kho kiến thức), tỉ lệ lượt phải viết lại (Lớp bảo vệ).
- Bài học: đáp án bộ thử phải cập nhật cùng dữ liệu, nếu không giám sát báo sai; chỉ test bằng phiên thử thì không thấy một số lỗi, nên vẫn đọc hội thoại thật mỗi ngày.
Khi triển khai cho doanh nghiệp khác, Aduca đặt mục tiêu theo giai đoạn: bộ thử đạt từ 90% đúng trở lên trước khi mở kênh thật; lỗi về kênh được cảnh báo trong 30 phút; hệ thống chạy ổn 2 tuần trước khi bàn giao. Đây là mục tiêu nội bộ khi triển khai, không phải cam kết kết quả kinh doanh.
Bắt đầu đo từ tuần này
- Chọn 3 chỉ số đầu tiên: tỉ lệ đúng thông tin, câu chưa trả lời được, khách nóng chưa được liên hệ.
- Soạn 20 câu thử đầu tiên chia theo 5 nhân vật, viết đáp án dạng "phải có / không được có".
- Đặt tiền tố cho phiên thử, chắc chắn phiên thử không báo Sale và không ghi CRM.
- Bật báo cáo cuối ngày với khung ở trên.
- Dành thời gian đọc hội thoại thật mỗi ngày, ưu tiên cuộc có vấn đề.
- Ghi lại quy trình: đổi giá, đổi lịch thì cập nhật đáp án bộ thử ngay.
Trình tự triển khai đầy đủ ở Lộ trình triển khai Sale Chat cho doanh nghiệp; giám sát kỹ thuật ở Giám sát lỗi, sao lưu workflow n8n.
Muốn Aduca dựng sẵn trợ lý bán hàng kèm bộ thử, báo cáo ngày và giám sát, xem Hệ thống Sale Chat tự động. Muốn tự dựng và tự đo bằng n8n, khóa Aduca AI Business System có module Sale Chat.
Câu hỏi thường gặp
Đo lường chatbot bán hàng nên bắt đầu từ chỉ số nào?
Bắt đầu từ ba chỉ số dễ hiểu: tỉ lệ trả lời đúng thông tin (giá, lịch, chính sách) trên bộ câu thử, số câu trợ lý chưa trả lời được mỗi ngày, và số khách nóng chưa được Sale liên hệ. Ba chỉ số này cho biết trợ lý có nói đúng không, kho kiến thức còn thiếu gì, và đoạn nối với đội Sale có rơi khách không.
Bộ câu thử cần bao nhiêu câu?
Không có con số bắt buộc. Aduca dùng 50 câu (5 nhân vật khách, mỗi nhân vật 10 câu) vì đủ phủ các tình huống chính mà vẫn chạy được mỗi đêm. Shop nhỏ có thể bắt đầu với 20 câu rồi bổ sung dần từ hội thoại thật.
Đổi giá rồi mà quên sửa bộ câu thử thì sao?
Bộ thử sẽ báo sai: trợ lý trả lời đúng giá mới nhưng bị chấm trượt vì đáp án còn giá cũ, hoặc ngược lại. Hãy coi việc cập nhật đáp án là một bước bắt buộc mỗi khi đổi bảng giá, bảng lịch.
Đã có bộ câu thử rồi, có cần đọc hội thoại thật không?
Có. Phiên thử dùng câu do người soạn, nên không tái hiện hết cách khách thật nhắn: nhắn dồn, gửi ảnh, viết tắt, đổi ý giữa chừng. Một số lỗi chỉ lộ ra khi đọc hội thoại thật, vì vậy nên dành thời gian đọc mỗi ngày.
Cho chatbot tự học từ hội thoại có an toàn không?
An toàn khi tự học chỉ dừng ở mức đề xuất. AI đọc hội thoại, ghi đề xuất bổ sung kịch bản vào bản nháp; chủ doanh nghiệp duyệt rồi mới đưa vào kho kiến thức. Không nên để AI tự sửa giá, chính sách hay kịch bản chính.
n8n có sẵn công cụ kiểm thử AI không?
n8n có tính năng Evaluations: chạy một bộ câu thử lưu trong data table hoặc Google Sheets qua workflow, xem kết quả và chấm điểm bằng chỉ số. Phần chấm điểm bằng chỉ số có giới hạn theo gói, nên kiểm tra tài liệu n8n tại thời điểm triển khai.
Tài liệu liên quan
- Sale Chat · AI AgentSale Chat Automation là gì? Hệ thống chốt sale qua inbox bằng AISale Chat Automation là gì: hệ thống chatbot bán hàng trả lời, dẫn dắt, chăm sóc khách qua Fanpage, Zalo OA, website; 4 tầng, 6 nguyên tắc vàng, ví dụ Aduca.
- Sale Chat · AI AgentKiến trúc Sale Chat: một lõi, nhiều kênh, nhiều thương hiệuKiến trúc chatbot bán hàng đa kênh: tin chuẩn, 4 tầng, 10 làn hành trình, gom tin nhắn dồn, đọc ảnh, đa thương hiệu bằng bảng cấu hình, chọn công cụ n8n.
- Sale Chat · AI AgentKịch bản chatbot bán hàng: dẫn dắt 6 bước như người thậtKịch bản chatbot bán hàng 6 bước: điều kiện lên bước, khai thác một ý mỗi lượt, tín hiệu mua, công thức trả lời, xử lý từ chối, chuyển người, mẫu để điền.
- Sale Chat · AI AgentKho kiến thức cho chatbot bán hàng: dữ liệu cứng, lời nói mềmCách xây dữ liệu cho chatbot bán hàng: một nguồn sự thật, giá và lịch để cứng, AI chỉ lo lời nói, thẻ kiến thức, tra trước, lối tắt, kèm mẫu ghi chú.
Xem tất cả tài liệu hướng dẫn →
Nhận báo giá Hệ thống Sale Chat tự động
Aduca dựng trợ lý AI bán hàng cho Fanpage, Zalo OA, website theo đúng sản phẩm, bảng giá và kịch bản của bạn, có báo Sale và chăm sóc khách tự động. Báo giá sau buổi khảo sát, theo số kênh, số sản phẩm và lượng tin nhắn.
Nguồn tham khảo
- n8n Docs – Vì sao cần kiểm thử workflow AI (Evaluations)
- n8n Docs – Light evaluations: chạy bộ câu thử nhanh
- n8n Docs – Metric-based evaluations: chấm điểm bằng chỉ số
- n8n Docs – Data tables
- n8n Docs – Schedule Trigger
- n8n Docs – Error Trigger
- Bộ Công an – Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15
Lịch sử cập nhật
- 11/11/2026 — Bản đầu.
Miễn trừ trách nhiệm
Bài viết thuộc chuỗi kiến thức của Công ty Cổ phần Giáo dục Aduca, chia sẻ miễn phí cho mục đích học tập. Thông tin kỹ thuật đối chiếu với tài liệu chính thức của các dự án và nền tảng tại ngày cập nhật (có ghi nguồn); phần nhận định là quan điểm của Aduca. OpenClaw, Hermes Agent, Claude (thương hiệu của Anthropic), ChatGPT (thương hiệu của OpenAI), n8n (thương hiệu của n8n GmbH), các phần mềm chạy model và các model AI mở (Ollama, LM Studio, Qwen, Gemma, gpt-oss…), Obsidian, Notion, phương pháp Building a Second Brain (Tiago Forte) cùng các phần mềm, dịch vụ nêu trong bài thuộc về chủ sở hữu tương ứng, không thuộc Aduca; Aduca không phải đối tác chính thức của các công ty này. Tính năng, gói và giá có thể thay đổi bất cứ lúc nào – hãy kiểm tra trang chính thức trước khi mua. Kết quả áp dụng phụ thuộc quy trình, dữ liệu và con người của từng doanh nghiệp; bài viết không cam kết doanh thu hay hiệu quả cụ thể. © 2026 Aduca — được trích dẫn khi ghi rõ nguồn aduca.vn.